지금까지 공부한 ADK의 메모리 서비스가 한 단계 발전하는 중요한 과정입니다.
앞서 InMemoryMemoryService와 VertexAiSessionService를 실습했다면, 이번에는 에이전트가 대화한 내용을 Google Cloud의 Vertex AI Memory Bank에 저장하고, 다음 대화에서 다시 검색해 활용하는 구조를 배우는 것입니다.
단순히 로컬 메모리를 클라우드 메모리로 바꾸는 것 이상의 의미가 있습니다.
이번 실습을 이해하려면 다음 세 가지를 명확하게 구분해야 합니다.
-
Agent Engine: Google Cloud에 메모리를 저장하고 관리할 클라우드 측 리소스입니다.
-
VertexAiMemoryBankService: 로컬 ADK 에이전트가 클라우드의 Memory Bank를 이용하도록 연결하는 서비스 계층입니다.
-
ADK Agent: 실제 사용자와 대화하고, 필요할 때 저장된 메모리를 검색해 답변하는 에이전트입니다.
전체 구조부터 살펴보겠습니다.
1. 전체 아키텍처
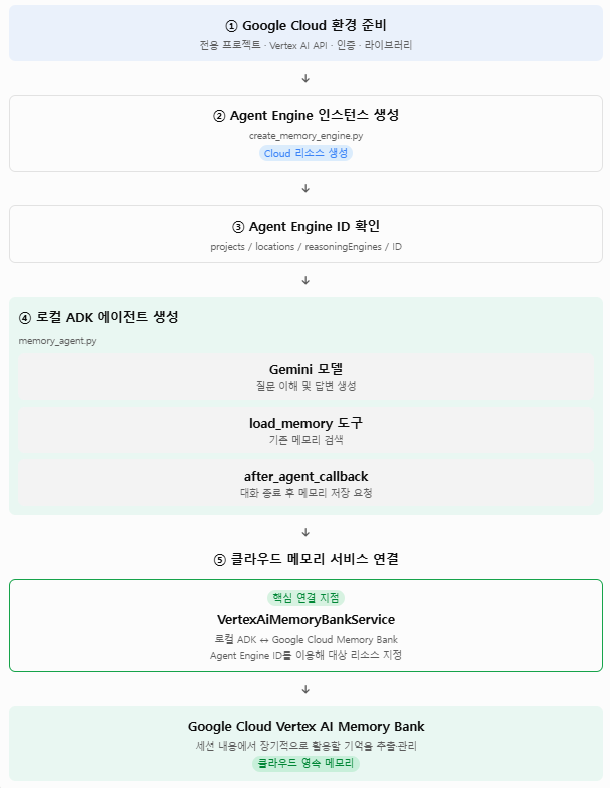
여기서 중요한 점이 하나 있습니다.
Agent Engine 인스턴스를 생성했다고 해서 그 자체가 곧 메모리 서비스가 되는 것은 아닙니다.
Agent Engine은 Memory Bank가 연결될 클라우드 리소스이고, 실제 ADK에서 메모리 기능을 사용하는 것은 VertexAiMemoryBankService가 담당합니다.
이제 각 단계를 살펴보겠습니다.
2. 1단계: Google Cloud 환경을 준비하는 이유
실습 전에 진행한 작업부터 이해해 보겠습니다.
| 준비 작업 | 목적 |
| 전용 GCP 프로젝트 생성 | 실습 리소스를 독립적으로 관리 |
| Vertex AI API 활성화 | Vertex AI 기능 사용 허용 |
| Google Cloud 인증 | 로컬 PC에서 GCP 리소스 접근 |
| 관련 라이브러리 설치 | Python 코드에서 Vertex AI API 호출 |
| Cloud Storage 버킷 생성 | Agent Engine 배포 파일 등의 임시 저장 공간 |
2-1. GCP 프로젝트
PROJECT_ID = "agent-project-512212"GCP 프로젝트는 클라우드 자원을 관리하는 기본 단위입니다.
이 프로젝트 안에서 다음과 같은 자원을 관리합니다.
-
Vertex AI
-
Agent Engine
-
Cloud Storage
-
API 사용량 및 과금
-
IAM 권한
우리 실습에서는 agent-project-512212라는 프로젝트를 기준으로 모든 클라우드 리소스에 접근합니다.
2-2. LOCATION
LOCATION = "asia-northeast3"이것은 클라우드 리소스를 생성할 지역입니다.
asia-northeast3는 서울 리전입니다.
클라우드 서비스를 사용할 때 리전은 중요합니다.
-
사용자와의 네트워크 거리
-
데이터 저장 위치
-
서비스 제공 가능 여부
-
지역별 과금 및 정책
이번 실습에서는 한국에서 접근하기 편리한 서울 리전을 사용하고 있습니다.
2-3. STAGING_BUCKET
STAGING_BUCKET = "gs://agent-project_512212-staging"이것은 Google Cloud Storage 버킷의 주소입니다.
gs://는 Google Cloud Storage의 버킷을 나타내는 URI 형식입니다.
Agent Engine을 생성하고 배포하는 과정에서는 Python 코드와 관련 파일, 의존성 등의 패키징 및 스테이징 작업이 필요합니다.
이때 임시 저장 공간으로 사용하는 것이 Staging Bucket입니다.
여기서 기억할 점은 다음과 같습니다.
Staging Bucket과 Memory Bank는 서로 다른 역할을 합니다.
-
Staging Bucket: 배포에 필요한 파일을 저장하는 공간
-
Memory Bank: 에이전트가 장기적으로 활용할 기억을 저장하는 서비스
Staging Bucket에 대화 기억이 저장되는 것은 아닙니다.
3. 2단계: create_memory_engine.py 상세 해설
이제 실제 코드입니다.
이 파일의 목적은 Google Cloud에 Agent Engine 리소스를 생성하고, 이후 ADK가 Memory Bank에 접근할 때 사용할 식별자를 확보하는 것입니다.
먼저 이 코드가 무엇을 하는지 큰 흐름을 보면 다음과 같습니다.
Google Cloud 프로젝트 지정
        ↓
테스트용 Agent 클래스 정의
        ↓
Vertex AI Client 생성
        ↓
Agent Engine 생성 요청
        ↓
생성된 리소스 정보 반환
        ↓
Agent Engine ID 추출
3-1. 라이브러리 가져오기
import vertexaivertexai는 Google Cloud의 Vertex AI 기능을 Python에서 사용하기 위한 라이브러리입니다.
이 라이브러리를 이용하면 다음과 같은 클라우드 작업을 수행할 수 있습니다.
-
Vertex AI 모델 이용
-
Agent Engine 생성 및 관리
-
에이전트 배포
-
Agent Engine 리소스 조회 및 삭제
여기서는 특히 vertexai.Client()와 agent_engines.create()를 사용합니다.
3-2. Google Cloud 프로젝트 설정
PROJECT_ID = "agent-project-512212"
LOCATION = "asia-northeast3"

STAGING_BUCKET = "gs://agent-project_512212-staging"
각 변수의 역할을 정리해 보겠습니다.
| 변수 | 값 | 역할 |
| PROJECT_ID | agent-project-512212 | 클라우드 프로젝트 식별 |
| LOCATION | asia-northeast3 | 리소스 생성 지역 |
| STAGING_BUCKET | gs://... | 배포 작업용 임시 저장 공간 |
여기서 주의할 점이 있습니다.
PROJECT_ID는 프로젝트 이름이 아니라 GCP에서 사용하는 프로젝트 ID입니다.
GCP 콘솔에서 프로젝트를 만들 때 지정한 프로젝트 ID를 정확하게 사용해야 합니다.
또한 버킷은 실제로 존재해야 하고, 현재 인증된 계정에 해당 버킷을 사용할 권한이 있어야 합니다.
3-3. 테스트용 Agent 클래스 정의
class SimpleAgent:
    def query(self, input: str, **kwargs):
        return {"message": f"Hello from Agent Engine: {input}"}
이번 코드에서 상당히 중요한 부분입니다.
처음 보면 왜 별도의 에이전트 클래스를 만들었는지 궁금할 수 있습니다.
이 클래스는 실제로 우리가 만든 memory_agent와 다른 객체입니다.
SimpleAgent는 Agent Engine을 생성하기 위해 전달하는 아주 간단한 테스트용 에이전트입니다.
내부를 살펴보겠습니다.
① 클래스 정의
class SimpleAgent:SimpleAgent라는 Python 클래스를 정의합니다.
② query 메서드
def query(self, input: str, **kwargs):Agent Engine이 호출할 수 있는 메서드입니다.
-
self: 해당 클래스의 인스턴스
-
input: str: 입력 문자열
-
**kwargs: 추가로 전달될 수 있는 여러 인자
③ 결과 반환
return {"message": f"Hello from Agent Engine: {input}"}예를 들어 다음과 같이 호출하면,
agent.query("안녕하세요")결과는 다음과 같습니다.
{ "message": "Hello from Agent Engine: 안녕하세요"}실제 Gemini를 호출하거나 기억을 검색하는 기능은 없습니다.
단순히 입력을 받아 문자열을 반환하는 테스트용 객체입니다.
그렇다면 왜 실제 memory_agent를 배포하지 않고 SimpleAgent를 사용했을까요?
이번 실습의 목적은 로컬 ADK 에이전트를 클라우드에 배포하는 것이 아닙니다.
클라우드에 Memory Bank를 연결할 수 있는 Agent Engine 리소스를 확보하고, 그 리소스를 로컬 ADK 에이전트에서 사용하려는 것입니다.
따라서 실제 업무를 수행하는 memory_agent와 Agent Engine 생성용 SimpleAgent를 구분해서 이해해야 합니다.
3-4. Vertex AI Client 생성
client = vertexai.Client(
    project=PROJECT_ID,
    location=LOCATION,
)
이제 Google Cloud와 통신할 클라이언트를 만듭니다.
여기서 client는 실제 클라우드 API를 호출할 수 있도록 해주는 Python 객체입니다.
각 인자를 살펴보겠습니다.
project=PROJECT_ID어느 GCP 프로젝트에서 작업할 것인지를 지정합니다.
location=LOCATION어느 리전에서 작업할 것인지를 지정합니다.
앞서 인증한 Application Default Credentials(ADC)를 이용해 Google Cloud에 접근합니다.
즉, 이 코드에서 인증정보를 직접 입력하지 않아도 되는 이유는 이미 로컬 환경에서 Google Cloud 인증을 진행했기 때문입니다.
일반적으로 다음 명령을 통해 인증합니다.
gcloud auth application-default login이 명령을 실행하면 로컬 PC에 Application Default Credentials가 설정되고, Google Cloud 라이브러리가 이를 활용합니다.
단, 인증했다고 모든 리소스에 접근할 수 있는 것은 아닙니다. 해당 계정에 필요한 IAM 권한도 있어야 합니다.
3-5. Agent Engine 생성 및 배포
이제 가장 중요한 부분입니다.
remote_agent = client.agent_engines.create(
    agent=SimpleAgent(),
    config={
        "display_name": "my-agent-engine",
        "description": "Created with vertexai.Client().agent_engines.create()",
        "staging_bucket": STAGING_BUCKET,
        "requirements": [
            "google-cloud-aiplatform[agent_engines, adk]==1.141.0",
            "cloudpickle==3.0.0",
            "pydantic==2.12.3",
        ],
    },
)
이 코드는 Google Cloud에 Agent Engine 생성 요청을 보냅니다.
하나씩 보겠습니다.
① agent=SimpleAgent()
agent=SimpleAgent()앞에서 정의한 클래스를 인스턴스화하여 전달합니다.
여기서 SimpleAgent()는 클래스 자체가 아니라 클래스의 객체입니다.
즉, 실제로 실행할 수 있는 인스턴스를 전달하는 것입니다.
② display_name
"display_name": "my-agent-engine"GCP 콘솔에서 리소스를 식별하기 위한 표시 이름입니다.
실습할 때는 my-agent-engine이라는 이름으로 확인할 수 있습니다.
③ description
"description": "Created with vertexai.Client().agent_engines.create()"해당 리소스에 대한 설명입니다.
리소스를 여러 개 만들 경우 어떤 용도로 생성했는지 구분하는 데 유용합니다.
④ staging_bucket
"staging_bucket": STAGING_BUCKETAgent Engine 생성 및 배포 과정에서 필요한 파일을 올려둘 Cloud Storage 버킷입니다.
⑤ requirements
"requirements": [
    "google-cloud-aiplatform[agent_engines, adk]==1.141.0",
    "cloudpickle==3.0.0",
    "pydantic==2.12.3",
]
이 부분은 상당히 중요합니다.
클라우드에 에이전트를 생성할 때는 해당 실행 환경에서 필요한 Python 패키지들을 준비해야 합니다.
여기서 requirements는 클라우드 측 실행 환경의 의존성 패키지를 지정하는 것입니다.
| 패키지 | 역할 |
| google-cloud-aiplatform | Vertex AI 및 Agent Engine API |
| agent_engines | Agent Engine 관련 기능 |
| adk | ADK 연동 기능 |
| cloudpickle | Python 객체 직렬화 및 역직렬화 |
| pydantic | 데이터 검증 및 모델 정의 |
특히 cloudpickle을 이해하면 좋습니다.
일반적인 Python 객체를 저장하고 다시 복원하는 데 사용되는 직렬화 라이브러리입니다.
Agent Engine은 Python 에이전트 객체를 클라우드 실행 환경으로 전달하고 실행할 수 있어야 하므로 이런 패키지가 필요합니다.
3-6. 버전 충돌 경고 해석
코드 아래에 다음과 같은 경고가 있었습니다.
The following requirements are incompatible:

{
'pydantic==2.13.5 (required: ==2.12.3)',
'cloudpickle==3.1.2 (required: ==3.0.0)'
}
이 메시지는 반드시 이해하고 넘어가야 합니다.
현재 지정한 버전과 실제 설치된 패키지 버전이 서로 다르다는 의미입니다.
| 패키지 | 요구 버전 | 충돌메시지의 버전 |
| pydantic | 2.12.3 | 2.13.5 |
| cloudpickle | 3.0.0 | 3.1.2 |
여기서 중요한 구분이 있습니다.
-
로컬 Python 환경의 패키지 버전
-
Agent Engine 클라우드 실행 환경의 패키지 버전
두 환경은 서로 다를 수 있습니다.
따라서 이 경고만으로 로컬 ADK 에이전트 실행이 실패한다고 판단해서는 안 됩니다.
다만 클라우드 배포 과정에서 의존성 충돌이 발생할 수 있으므로, 실제 생성 결과와 클라우드 로그를 확인해야 합니다.
제 권장 사항은 다음과 같습니다.
-
requirements에 명시한 버전들이 서로 호환되는지 확인합니다.
-
특별한 이유가 없다면 무조건 과거 버전을 고정하지 않습니다.
-
실습에 사용한 google-cloud-aiplatform, google-adk, pydantic, cloudpickle의 실제 버전을 기록합니다.
-
Agent Engine의 생성 상태 및 실행 로그를 확인합니다.
참고로 이번 코드의 목적이 단지 Memory Bank 리소스를 확보하는 것이라면, SimpleAgent의 실제 실행 기능과 메모리 기능은 별개입니다.
4. 3단계: 생성된 Agent Engine ID 확인 및 추출
print("Agent Engine 생성 요청 완료")
print(remote_agent)
첫 번째 줄은 작업이 끝났다는 안내 메시지를 출력합니다.
두 번째 줄은 remote_agent 객체의 정보를 출력합니다.
그런데 우리가 정말 필요한 정보는 객체 전체가 아니라 Agent Engine의 고유 리소스 ID입니다.
if hasattr(remote_agent, "api_resource"):
	print("Resource name: ", remote_agent.api_resource.name)
하나씩 이해해 보겠습니다.
① hasattr()
hasattr(remote_agent, "api_resource")Python의 내장 함수입니다.
특정 객체가 지정한 속성을 가지고 있는지 확인합니다.
여기서는 remote_agent 객체에 api_resource라는 속성이 존재하는지 확인합니다.
② remote_agent.api_resource
Agent Engine 생성 결과에 포함된 클라우드 리소스 정보입니다.
③ .name
remote_agent.api_resource.name리소스의 전체 이름을 가져옵니다.
예를 들어 다음과 같은 형태입니다.
projects/921865052026/locations/asia-northeast3/reasoningEngines/2528612861094133760이것이 바로 다음 단계에서 사용할 핵심 정보입니다.
구조를 나누어 보겠습니다.
| 구성 | 요소값 | 의미 |
| projects | projects | GCP 프로젝트 리소스 |
| 프로젝트 번호 | 921865052026 | 프로젝트 고유 번호 |
| locations | locations | 리전 정보 |
| 리전 | asia-northeast3 | 서울 |
| reasoningEngines | reasoningEngines | Agent Engine 리소스 유형 |
| ID | 2528612861094133760 | 개별 Agent Engine 식별자 |
여기서 주의할 점이 있습니다.
앞서 코드에서는 프로젝트 ID로 agent-project-512212를 사용했지만, 리소스 이름에는 프로젝트 번호인 921865052026이 표시됩니다.
둘은 서로 다른 값이지만 동일한 GCP 프로젝트를 식별할 수 있습니다.
프로젝트 ID와 프로젝트 번호를 혼동하지 않는 것이 중요합니다.
실제로 ADK 실행 명령에는 이 전체 리소스 이름을 사용하고 있습니다.
5. 4단계: 로컬 ADK 에이전트 코드 상세 해설
이제 실제로 사용자와 대화할 에이전트를 살펴보겠습니다.
여기부터는 우리가 앞서 공부한 ADK의 구성 요소들이 다시 등장합니다.
-
Agent
-
CallbackContext
-
Tools
-
load_memory
-
after_agent_callback
이번에는 각각의 역할이 Memory Bank와 어떻게 연결되는지 이해하는 것이 중요합니다.
5-1. 라이브러리 가져오기
import os
from typing import Optional

from google.adk import Agent
from google.adk.agents.callback_context import CallbackContext
from google.adk.tools import load_memory

import google.adk as adk
from google.genai import types
각 라이브러리를 살펴보겠습니다.
| os | 환경변수 접근 |
| Optional | 반환값의 타입 표시 |
| Agent | ADK 에이전트 생성 |
| CallbackContext | 에이전트 콜백 실행 문맥 |
| load_memory | 저장된 메모리 검색 도구 |
| google.adk | ADK 패키지 |
| google.genai.types | Gemini 및 ADK에서 사용하는 데이터 타입 |
여기서 몇 가지는 현재 코드에서 실제로 사용되지 않습니다.
import google.adk as adk현재 코드에는 adk라는 이름을 직접 사용하는 부분이 없습니다.
마찬가지로 Optional과 types.Content는 콜백의 반환 타입을 표시하는 데 사용하고 있습니다.
불필요한 import를 정리하면 코드가 더 간결해질 수 있습니다.
5-2. add_session_to_memory 함수
이번 코드의 핵심 중 하나입니다.
async def add_session_to_memory(
    callback_context: CallbackContext
) -> Optional[types.Content]:
먼저 이 함수가 무슨 역할을 하는지 이해해 봅시다.
에이전트가 사용자와 대화를 마치면, 그 세션의 대화 기록을 Memory Bank에 전달하도록 요청하는 함수입니다.
이전에 배웠던 일반적인 Python 함수와 다른 점이 있습니다.
① async def
async def add_session_to_memory(...)비동기 함수입니다.
일반 함수는 다음과 같이 호출합니다.
result = my_function()반면 비동기 함수는 일반적으로 다음과 같이 실행합니다.
result = await my_function()왜 비동기로 만들었을까요?
Memory Bank에 대화 기록을 전달하려면 Google Cloud와 네트워크 통신을 해야 합니다.
네트워크 요청이 끝날 때까지 기다리는 동안 다른 비동기 작업을 수행할 수 있도록 설계한 것입니다.
② callback_context
callback_context: CallbackContext이것은 ADK가 콜백을 실행할 때 전달하는 문맥 객체입니다.
앞서 공부했던 ToolContext와 비슷한 개념으로 생각하면 이해하기 쉽습니다.
다만 역할이 다릅니다.
| 객체 | 사용되는 곳 | 역할 |
| ToolContext | Tool 실행 시 | 도구 실행에 필요한 문맥과 상태 접근 |
| CallbackContext | Callback 실행 시 | 에이전트 실행 과정의 정보와 기능 접근 |
이번에는 CallbackContext를 통해 현재 에이전트의 실행 정보를 확인합니다.
③ Optional[types.Content]
-> Optional[types.Content]함수의 반환 타입을 표시한 것입니다.
Optional[X]는 X 또는 None을 반환할 수 있다는 뜻입니다.
즉 다음과 같은 의미입니다.
types.Content 또는 None이 콜백은 특별한 응답을 사용자에게 반환하는 것이 목적이 아니라 메모리 저장을 수행하는 것이므로, 실제로는 None을 반환하는 경우가 일반적입니다.
5-3. 내부 코드 해설
if hasattr(callback_context, "_invocation_context"):먼저 CallbackContext 객체가 _invocation_context라는 속성을 가지고 있는지 검사합니다.
여기서 _로 시작하는 속성은 Python에서 일반적으로 내부 구현용이라는 의미를 가집니다.
즉 ADK가 내부적으로 관리하는 실행 문맥에 접근하는 것입니다.
invocation_context = callback_context._invocation_context현재 에이전트 실행에 관한 내부 문맥 객체를 가져옵니다.
이 객체에는 에이전트 실행과 관련된 여러 정보가 들어 있습니다.
그중 이번 실습에서 필요한 정보는 다음 두 가지입니다.
-
memory_service
-
session
이제 다음 코드를 보겠습니다.
if invocation_context.memory_service:현재 실행 환경에 메모리 서비스가 설정되어 있는지 확인합니다.
우리가 실행할 때 다음 명령을 사용했죠.
adk web --port 8080 --memory_service_uri="agentengine://..."이 옵션으로 지정한 Memory Bank 서비스가 ADK 실행 환경에 연결되면 invocation_context.memory_service를 통해 접근할 수 있습니다.
즉 다음과 같은 구조입니다.
adk web 실행
     ↓
memory_service_uri 설정
     ↓
ADK가 Memory Service 생성
     ↓
InvocationContext에 연결
     ↓
callback_context를 통해 접근
이제 가장 중요한 코드입니다.
await invocation_context.memory_service.add_session_to_memory(
	invocation_context.session
)
이 부분이 실제로 대화 내용을 Memory Bank에 전달하는 부분입니다.
두 가지를 나누어 보겠습니다.
① invocation_context.session
현재 대화 세션 객체입니다.
세션에는 일반적으로 다음과 같은 정보가 들어 있습니다.
-
app_name
-
user_id
-
session_id
-
events
여기서 특히 중요한 것은 events입니다.
대화 중 발생한 사용자 메시지, 에이전트 응답 등의 이벤트가 포함됩니다.
예를 들어 다음과 같이 대화했다고 가정하겠습니다.
사용자: 나는 서울에 살고 있어.

에이전트: 네, 서울에 거주하시는군요.

사용자: 나는 Python과 AI Agent 공부를 계속할 생각이야.

에이전트: 좋은 계획이네요. 앞으로 학습을 도와드리겠습니다.
이러한 대화가 세션의 이벤트로 기록됩니다.
② add_session_to_memory()
add_session_to_memory(session)세션에 포함된 이벤트를 Memory Bank에 전달하는 메서드입니다.
여기서 매우 중요한 사실이 있습니다.
이 메서드는 단순히 대화 내용을 그대로 파일처럼 저장하는 것이 아닙니다.
Vertex AI Memory Bank는 전달된 대화 이벤트를 바탕으로 의미 있는 기억을 생성하고 관리합니다.
예를 들어 다음과 같은 기억을 추출할 수 있습니다.
사용자는 서울에 거주한다.

사용자는 Python과 AI Agent를 지속적으로 공부할 계획이다.
즉, 대화 기록에서 향후 대화에 도움이 될 만한 정보를 추출하는 과정이 포함됩니다.
이것이 일반적인 대화 로그 저장과 Memory Bank의 중요한 차이입니다.
공식 문서에서도 add_session_to_memory()는 세션 이벤트를 Memory Bank에 전달해 메모리 생성을 요청하는 기능으로 설명하고 있습니다.
5-4. 현재 콜백 코드에서 개선할 부분
여기서는 한 가지 더 깊이 짚고 넘어가겠습니다.
현재 코드는 다음과 같이 내부 속성에 직접 접근합니다.
callback_context._invocation_context이 방식은 현재 사용 중인 ADK 버전에서 동작할 수 있지만, _invocation_context는 내부 구현 속성입니다.
ADK 내부 구조가 바뀌면 영향을 받을 수 있습니다.
최근 ADK의 CallbackContext에는 메모리 서비스에 세션을 전달하는 편의 메서드가 제공됩니다.
따라서 다음과 같이 작성하는 방법을 권장합니다.
async def add_session_to_memory(
    callback_context: CallbackContext
) -> None:

    await callback_context.add_session_to_memory()
이 코드의 의미는 간단합니다.
-
ADK가 콜백을 호출합니다.
-
CallbackContext가 현재 실행 문맥을 가지고 있습니다.
-
add_session_to_memory()를 호출합니다.
-
현재 세션의 이벤트가 설정된 Memory Service로 전달됩니다.
내부 InvocationContext를 직접 꺼내지 않아도 됩니다.
이 방식은 ADK가 제공하는 공개 인터페이스를 이용한다는 점에서 유지보수에 더 유리합니다.
단, 실습 환경의 ADK 버전에서 이 메서드가 지원되는지 확인해야 합니다. 공식 ADK Memory Bank 문서의 CallbackContext 관련 설명을 기준으로 적용하면 됩니다.
'Agentic AI > Google ADK' 카테고리의 다른 글
| 21. Session/Memory/Artifact [10]- VertexAiMemoryBankService(2/2) (0) | 2026.10.31 |
|---|---|
| 19. Session/Memory/Artifact [8]- InMemoryMemoryService (0) | 2026.10.25 |
| 18. Session/Memory/Artifact [7]- VertexAiSessionService(3/3) (0) | 2026.10.25 |
| 17. Session/Memory/Artifact [6]- VertexAiSessionService(2/3) (0) | 2026.10.25 |
| 16. Session/Memory/Artifact [5]- VertexAiSessionService(1/3) (0) | 2026.10.25 |