먼저 이 프로젝트를 한 문장으로 정의하면 다음과 같습니다.
Google ADK로 전문 에이전트를 만들고, A2A 프로토콜로 각 에이전트를 독립 서버로 공개한 다음, Manager Agent가 이들을 병렬·순차적으로 조율하여 최종 여행 계획서를 생성하는 분산형 멀티 에이전트 시스템입니다.
아래 설명은 첨부된 코드의 실제 흐름을 기준으로 합니다. 코드를 그대로 해설하는 것에 더해, 현재 구조의 장점과 보완할 점도 구분해서 설명하겠습니다.
1. 프로젝트 전체 구조
1-1. 폴더와 파일의 역할
adk_2/
│
├── .env
├── requirements.txt
├── test_gemini_api.py
├── test_a2a.py
│
├── common/
│   ├── __init__.py
│   └── agent_cards.py
│
├── remote_weather_agent/
│   ├── __init__.py
│   └── agent.py
│
├── remote_research_agent/
│   ├── __init__.py
│   └── agent.py
│
├── remote_document_agent/
│   ├── __init__.py
│   └── agent.py
│
└── manager_agent/
    ├── __init__.py
    └── agent.py
각 파일의 역할을 크게 나누면 다음과 같습니다.
| 파일·폴더 | 역할 |
| .env | API Key와 모델 등 공통 환경 설정 |
| requirements.txt | 프로젝트에서 사용하는 Python 패키지 목록 |
| test_gemini_api.py | Gemini API 연결 테스트 |
| test_a2a.py | 원격 에이전트 3개와 A2A 통신 테스트 |
| common/agent_cards.py | 공통 Agent Card 생성 |
| remote_weather_agent | 날씨 전문 에이전트 서버 |
| remote_research_agent | 여행 정보 조사 전문 에이전트 서버 |
| remote_document_agent | 여행 계획서 작성 및 저장 서버 |
| manager_agent | 세 원격 에이전트를 통제하는 총괄 에이전트 |
여기서 각 폴더에 있는 __init__.py는 해당 디렉터리를 Python 패키지로 취급하도록 하는 파일입니다. 현재 내용이 비어 있어도 괜찮습니다.
예를 들어 다음 import가 가능해지는 데 도움이 됩니다.
from remote_weather_agent import agent
from common.agent_cards import create_agent_card
최근 Python에서는 일부 상황에서 __init__.py 없이도 패키지를 구성할 수 있지만, 학습 프로젝트에서는 명시적으로 두는 편이 구조를 이해하기 쉽습니다.
1-2. 시스템 아키텍처: 네 개의 에이전트가 협업하는 방식
이 프로젝트에는 네 개의 ADK Agent가 있습니다. 다만 역할은 서로 다릅니다.
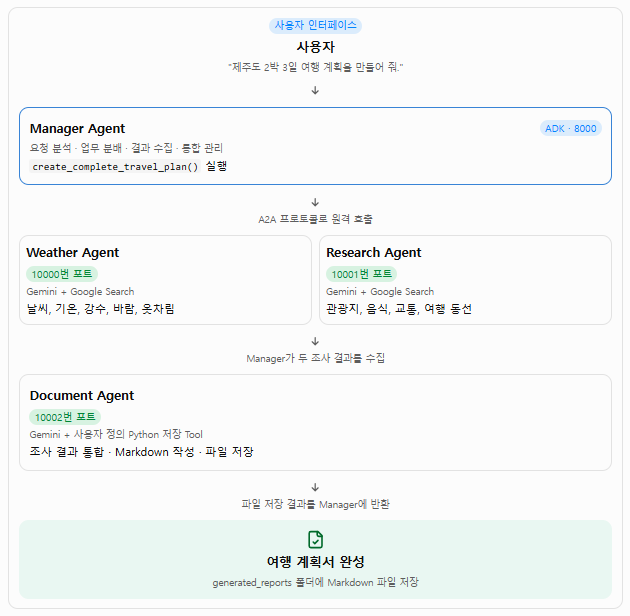
이 구조에서 꼭 이해해야 할 세 가지
첫째, Manager Agent가 모든 일을 직접 수행하지 않습니다.
Manager는 사용자의 요청을 파악하고 각 전문 에이전트에 일을 맡깁니다. 날씨 조사나 관광지 조사를 직접 수행하는 대신, 결과를 모으고 통합하는 데 집중합니다.
둘째, 원격 에이전트는 독립적인 서버입니다.
Weather, Research, Document는 각각 별도의 Python 프로세스로 실행됩니다. 한 서버의 코드가 다른 서버의 Python 함수를 직접 호출하는 방식이 아닙니다.
셋째, A2A는 이 독립된 에이전트들을 연결하는 통신 규약입니다.
현재는 한 컴퓨터의 localhost를 사용하지만, 나중에는 서로 다른 컴퓨터나 클라우드 서버에 배치할 수도 있습니다.
2. 프로젝트 실행 전에 알아야 할 환경 설정
2-1. .env 파일
현재 내용은 다음과 같습니다.
GOOGLE_GENAI_USE_ENTERPRISE=0
GOOGLE_API_KEY=나의 api key
GOOGLE_MODEL=gemini-3.5-flash
각 설정의 의미는 다음과 같습니다.
| 변수 | 설명 |
| GOOGLE_GENAI_USE_ENTERPRISE | Google GenAI의 Enterprise 사용 경로를 선택하는 환경 설정 |
| GOOGLE_API_KEY | Gemini API 인증 키 |
| GOOGLE_MODEL | 에이전트들이 사용할 모델 이름 |
각 Agent는 다음 코드로 모델 이름을 가져옵니다.
model=os.getenv(
    "GOOGLE_MODEL",
    "gemini-3.5-flash"
)
os.getenv()는 운영체제 환경변수에서 값을 가져옵니다. 첫 번째 인자로 지정한 변수가 없으면 두 번째 인자를 기본값으로 사용합니다. 이렇게 설정하면 모델을 변경할 때 네 개의 agent.py 파일을 각각 수정할 필요가 없습니다. .env의 모델 설정만 바꾸면 됩니다.
보안상 주의할 점
실제 API Key가 들어 있는 .env는 GitHub 등에 올리면 안 됩니다. .gitignore에 다음 항목을 추가하는 것이 좋습니다.
.env
.venv/
__pycache__/
*.pyc
generated_reports/
그리고 .env.example에는 실제 키 대신 다음처럼 작성하면 됩니다.
GOOGLE_GENAI_USE_ENTERPRISE=0
GOOGLE_API_KEY=여기에_API_KEY_입력
GOOGLE_MODEL=사용할_모델명
GOOGLE_MODEL에 지정한 모델명은 실제 사용 시점에 API에서 지원되고 계정에 접근 권한이 있는지 확인해야 합니다.
2-2. requirements.txt
이 파일은 프로젝트 실행에 필요한 Python 패키지와 버전을 관리합니다.
예를 들어 이 프로젝트에서는 개념적으로 다음 계열의 패키지가 필요합니다.
-
google-adk: Agent와 Tool을 구성하는 ADK
-
a2a-sdk: A2A 메시지와 Client, Agent Card
-
python-dotenv: .env 로딩
-
google-genai: Gemini API Client
-
uvicorn: 원격 Agent 서버 실행
다만 첨부 내용에서는 requirements.txt의 실제 내용이 생략되어 있으므로, 지금 설치된 정확한 버전과 패키지 간 호환성까지는 판정할 수 없습니다. 이 프로젝트에서는 특히 google-adk와 a2a-sdk 버전이 중요합니다. A2A Client의 클래스와 메서드 시그니처는 SDK 버전에 따라 달라질 수 있기 때문입니다. 실행 환경을 기록하려면 다음 명령이 유용합니다.
python -m pip freeze > requirements-lock.txtrequirements.txt가 설치할 패키지의 주요 의존성을 관리하는 파일이라면, requirements-lock.txt는 현재 설치된 구체적인 버전 조합을 보존하는 데 사용할 수 있습니다.
2-3. 모든 Agent가 .env를 읽는 방법
원격 에이전트와 Manager에는 다음과 같은 코드가 있습니다.
PROJECT_ROOT = Path(__file__).resolve().parents[1]

ENV_FILE = PROJECT_ROOT / ".env"

load_dotenv(
    dotenv_path=ENV_FILE,
    override=True
)
현재 파일이 다음 경로에 있다고 가정해 보겠습니다.
adk_2/remote_weather_agent/agent.py그러면:
-
Path(__file__): 현재 agent.py 경로
-
.resolve(): 절대 경로로 변환
-
.parents[1]: 두 단계 위인 adk_2
-
/ ".env": 프로젝트 최상위의 .env 경로
즉, PowerShell의 현재 작업 디렉터리가 어디인지에 관계없이 프로젝트의 .env를 찾도록 만든 것입니다.
override=True는 이미 운영체제에 같은 환경변수가 있더라도 .env에 적힌 값으로 덮어쓰는 옵션입니다.
코드 개선 포인트
현재 Weather, Research, Document 코드에는 명시적인 .env 로딩 후에 아래와 같은 코드가 다시 등장합니다.
import os
from dotenv import load_dotenv

load_dotenv(override=True)
이것은 앞의 명시적인 .env 로딩과 중복입니다. 더구나 두 번째 호출은 파일 경로를 지정하지 않으므로 실행 위치에 따라 다른 .env를 읽을 가능성이 있습니다.
권장: 각 agent.py에서는 첫 번째 명시적 로딩만 유지하고, 두 번째 import os, load_dotenv() 및 load_dotenv(override=True)는 제거하는 편이 안전합니다. 또한 현재 API Key가 있는지만 확인하는 코드는 좋습니다.
api_key = os.getenv("GOOGLE_API_KEY", "").strip()

if not api_key:
    raise RuntimeError(
        f"GOOGLE_API_KEY를 찾을 수 없습니다: {ENV_FILE}"
    )
API Key의 실제 문자열은 출력하지 않고 존재 여부만 확인하므로 보안 측면에서도 바람직합니다.
3. Gemini API와 A2A 사전 테스트
본격적으로 네 개의 에이전트를 실행하기 전에 두 개의 테스트 파일을 만든 이유가 있습니다.
시스템을 구성할 때는 문제가 발생한 위치를 좁힐 수 있어야 합니다.
-
Gemini API 자체가 안 되는 것인가?
-
원격 Agent 서버가 실행되지 않는 것인가?
-
A2A 통신이 안 되는 것인가?
-
Manager의 작업 분배나 결과 통합에서 문제가 생기는 것인가?
이것을 구분하기 위한 것이 두 테스트 파일입니다.
3-1. test_gemini_api.py: Gemini 연결 테스트
전체 코드를 다시 보겠습니다.
import os
from pathlib import Path
from dotenv import load_dotenv
from google import genai

# 1. 최상위 .env 로드
PROJECT_ROOT = Path(__file__).resolve().parent
load_dotenv(PROJECT_ROOT / ".env", override=True)

# 2. API Key와 모델 확인
api_key = os.getenv("GOOGLE_API_KEY", "").strip()
model_name = os.getenv("GOOGLE_MODEL", "gemini-3.5-flash")

if not api_key:
    raise RuntimeError("GOOGLE_API_KEY가 설정되지 않았습니다.")

print("API Key 로드 여부:", bool(api_key))
print("모델:", model_name)

# 3. Gemini API Client 생성
client = genai.Client(api_key=api_key)

# 4. 실제 Gemini API 호출
try:
    response = client.models.generate_content(
        model=model_name,
        contents="안녕하세요. Gemini API 연결 테스트입니다."
    )

    print("\n[성공] Gemini API 호출 정상")
    print("응답:")
    print(response.text)

except Exception as e:
    print("\n[실패] Gemini API 호출 오류")
    print("오류 유형:", type(e).__name__)
    print("오류 내용:", e)

finally:
    client.close()
이 코드는 네 단계로 이해하면 됩니다.
① .env를 읽습니다.
PROJECT_ROOT = Path(__file__).resolve().parent
load_dotenv(PROJECT_ROOT / ".env", override=True)
test_gemini_api.py는 adk_2 바로 아래에 있으므로 .parent가 곧 프로젝트 최상위 폴더입니다.
앞서 원격 Agent에서 .parents[1]을 썼던 것과 차이가 있습니다.
② API Key와 모델명을 가져옵니다.
api_key = os.getenv("GOOGLE_API_KEY", "").strip()
model_name = os.getenv("GOOGLE_MODEL", "gemini-3.5-flash")
strip()은 문자열 앞뒤의 공백을 제거합니다.
API Key가 없으면 다음 코드로 중단합니다.
if not api_key:
    raise RuntimeError(...)
이것은 인증 정보가 없는 상태에서 불필요한 API 호출을 시도하지 않도록 하는 사전 검증입니다.
③ Gemini Client를 만듭니다.
client = genai.Client(api_key=api_key)Client는 Gemini API와 통신하기 위한 객체입니다.
④ 실제 모델을 호출합니다.
response = client.models.generate_content(
    model=model_name,
    contents="안녕하세요. Gemini API 연결 테스트입니다."
)
여기서 generate_content()가 실제 API 요청을 수행합니다. 응답은 response에 저장됩니다. 그리고 response.text로 생성된 텍스트를 확인합니다. 마지막의 finally는 성공과 실패에 관계없이 Client를 닫아 자원을 정리합니다.
이 테스트가 검증하는 범위
| 테스트 항목 | 확인 여부 |
| .env 파일 로딩 | 확인 |
| API Key 존재 여부 | 확인 |
| Gemini API 인증 및 접근 | 실제 호출로 확인 |
| 모델 응답 생성 | 확인 |
| Google Search Tool | 확인하지 않음 |
| A2A 통신 | 확인하지 않음 |
| Manager의 오케스트레이션 | 확인하지 않음 |
즉, Gemini API가 작동한다고 해서 전체 멀티 에이전트가 정상 작동한다는 뜻은 아닙니다.
이 테스트는 AI 모델과의 연결 상태만 확인하는 1단계 테스트입니다.
3-2. test_a2a.py: 원격 에이전트 통신 테스트
이제 두 번째 테스트입니다.
import asyncio

from a2a.client.client_factory import ClientFactory
from a2a.helpers import new_text_message
from a2a.types import SendMessageRequest, Role
이 파일에서 중요한 것은 A2A SDK의 세 가지 구성 요소입니다.
| 구성 요소 | 역할 |
| ClientFactory | 원격 Agent와 통신할 Client 생성 |
| new_text_message | A2A 메시지 생성 |
| SendMessageRequest | 메시지를 전송할 요청 객체 생성 |
① 원격 Agent 주소 등록
AGENTS = {
    "Weather": "http://localhost:10000/",
    "Research": "http://localhost:10001/",
    "Document": "http://localhost:10002/",
}
여기에는 세 개의 원격 Agent 주소가 저장되어 있습니다.
localhost는 현재 컴퓨터를 의미합니다.
현재는 세 개의 Agent를 같은 컴퓨터에서 실행하므로 다음처럼 포트를 구분합니다.
-
10000: Weather
-
10001: Research
-
10002: Document
이 구조는 나중에 서버를 분리할 때도 유용합니다.
예를 들어 실제 운영 환경에서는 다음처럼 구성할 수 있습니다.
Weather Agent  → weather.example.com
Research Agent → research.example.com
Document Agent → document.example.com
Manager는 원격 주소만 알면 됩니다. 상대 에이전트의 내부 Python 코드를 알 필요가 없습니다.
② test_agent() 함수
async def test_agent(name, url):
    client = None

    try:
        print(f"\n[{name}] 테스트 시작")

        factory = ClientFactory()
        client = await factory.create_from_url(url)
이 함수는 하나의 원격 Agent를 테스트합니다. async def는 비동기 함수를 정의합니다.
await는 비동기 작업이 끝날 때까지 기다립니다.
client = await factory.create_from_url(url)이 코드에서 ClientFactory는 주어진 URL을 통해 원격 Agent의 정보를 확인하고, 통신에 사용할 Client를 생성합니다.
여기서 Agent Card가 중요한 역할을 합니다. 원격 Agent가 어떤 주소에서 어떤 프로토콜을 지원하는지 파악하는 출발점이기 때문입니다.
③ 메시지 생성
message = new_text_message(
    text=f"안녕하세요. 저는 {name} 에이전트 통신 테스트를 하고 있습니다. 정상적으로 응답해 주세요.",
    role=Role.ROLE_USER,
)
여기서는 단순한 텍스트 메시지를 생성합니다.
예를 들어 Weather Agent에는 다음과 같은 요청이 전달됩니다.
안녕하세요. 저는 Weather 에이전트 통신 테스트를 하고 있습니다.
정상적으로 응답해 주세요.
Role.ROLE_USER는 메시지의 발신자 역할을 나타냅니다.
④ 요청 객체 생성
request = SendMessageRequest(message=message)이 부분은 메시지를 A2A 요청 형식으로 감싸는 과정입니다.
A2A 통신을 이해할 때 다음처럼 생각하면 편합니다.
-
message: 전달할 실제 내용
-
SendMessageRequest: 그 내용을 전송하기 위한 프로토콜 요청
⑤ 원격 Agent 호출
async for response in client.send_message(request):
    print(f"[{name}] 응답 객체:")
    print(response)
여기서는 async for를 사용합니다.
A2A Client가 반환하는 비동기 응답 흐름을 순회하면서 수신된 결과를 출력합니다.
다만 여기서 한 가지 주의할 점이 있습니다.
현재 코드의 client.send_message()와 SendMessageRequest의 사용법은 설치된 A2A SDK 버전과 일치해야 합니다. 실제로 이 코드가 정상 실행되는 환경이라면 그 환경의 호출 방식을 유지하는 것이 좋습니다. SDK를 업그레이드할 때는 메서드 시그니처를 먼저 확인해야 합니다.
⑥ 오류 처리와 연결 정리
except Exception as e:
    print(f"[{name}] 통신 실패")
    print(type(e).__name__, e)

finally:
    if client is not None:
        await client.close()
except는 통신 중 발생한 예외를 출력합니다.
finally는 성공 또는 실패와 관계없이 실행됩니다.
client.close()는 통신에 사용한 Client를 정리합니다.
⑦ 세 Agent를 순서대로 검사
async def main():
    for name, url in AGENTS.items():
        await test_agent(name, url)
이 코드는 다음 순서로 실행됩니다.
Weather Agent 테스트
        ↓
Research Agent 테스트
        ↓
Document Agent 테스트
현재는 순차 실행입니다. 첫 번째 테스트가 끝나야 두 번째 테스트가 시작됩니다.
실제 Manager에서는 Weather와 Research를 병렬 실행하므로 두 방식은 다릅니다.
⑧ 프로그램 시작점
if __name__ == "__main__":
    asyncio.run(main())
이 코드는 test_a2a.py를 직접 실행할 때 main()을 시작합니다.
asyncio.run()은 비동기 프로그램의 실행 진입점입니다.
이 테스트에서 꼭 기억할 것
test_a2a.py가 성공한다는 것은 원격 Agent와 기본적인 A2A 요청·응답이 가능하다는 뜻입니다.
그러나 실제 여행 조사 요청까지 성공한다는 뜻은 아닙니다.
예를 들어 다음은 서로 다른 테스트입니다.
-
"안녕하세요. 응답해 주세요." → 간단한 A2A 응답 테스트
-
"제주도의 2박 3일 날씨와 관광지를 조사해 주세요." → Gemini 추론과 검색 Tool까지 포함한 업무 테스트
따라서 간단한 통신 테스트는 성공하는데 실제 업무는 시간 초과가 발생할 수 있습니다. 이 점이 앞서 겪었던 Timeout 문제를 이해하는 데도 중요합니다.
4. 공통 모듈: common/agent_cards.py
이 파일은 작지만 설계적으로 매우 중요합니다.
왜냐하면 세 원격 Agent가 각자 Agent Card를 만들 때 중복 코드를 작성하지 않도록 해주기 때문입니다.
4-1. Agent Card 관련 클래스 가져오기
from a2a.types import (
    AgentCard,
    AgentSkill,
    AgentInterface,
    AgentCapabilities,
)
각 클래스의 역할을 살펴보겠습니다.
| 클래스 | 의미 |
| AgentCard | 에이전트의 전체 소개 정보 |
| AgentSkill | 에이전트가 수행할 수 있는 업무 |
| AgentInterface | 에이전트에 접근하는 통신 주소와 프로토콜 |
| AgentCapabilities | 에이전트가 지원하는 기능 |
여기서 Agent Card는 에이전트의 명함이고, Skill은 그 명함에 적힌 전문 분야라고 이해하면 됩니다.
4-2. 공통 함수 정의
def create_agent_card(
    name: str,
    description: str,
    skill_id: str,
    skill_name: str,
    skill_description: str,
    tags: list[str],
    port: int,
) -> AgentCard:
이 함수는 에이전트별로 다른 값만 입력받아 표준 Agent Card를 생성합니다.
함수의 반환 타입을 -> AgentCard로 지정했습니다.
즉, 이 함수는 AgentCard 객체를 반환하도록 설계했다는 뜻입니다.
① Skill 정의
skill = AgentSkill(
    id=skill_id,
    name=skill_name,
    description=skill_description,
    tags=tags,
)
이 부분은 해당 에이전트가 어떤 업무를 전문적으로 수행하는지 정의합니다.
예를 들어 Weather Agent는 다음 정보를 넣습니다.
id: realtime_weather_lookup
name: 실시간 기상 분석
tags: weather, realtime, forecast, travel
Research Agent는 다른 Skill을 등록합니다.
id: travel_destination_research
name: 여행지 전문 조사
tags: travel, research, tourism, attractions
즉, Agent Card는 동일한 구조를 사용하지만 각각의 전문성은 다르게 표현됩니다.
② Interface 정의
interface = AgentInterface(
    url=f"http://localhost:{port}/",
    protocol_binding="JSONRPC",
    protocol_version="1.0",
)
이 부분은 통신 주소를 정의합니다.
예를 들어 port=10000이면 다음 주소가 만들어집니다.
http://localhost:10000/protocol_binding="JSONRPC"는 JSON-RPC 방식으로 통신한다는 것을 나타냅니다.
protocol_version="1.0"은 이 Interface에서 선언하는 프로토콜 버전입니다.
중요한 점은 Agent Card가 단순한 소개 문서가 아니라 통신에 필요한 메타데이터를 제공한다는 것입니다.
③ Capabilities 정의
capabilities = AgentCapabilities(
    streaming=False,
    push_notifications=False,
    extended_agent_card=False,
)
여기서는 세 가지 기능을 선언합니다.
| 설정 | 의미 |
| streaming=False | 스트리밍 기능을 지원하지 않는다고 선언 |
| push_notifications=False | Push 알림 기능을 지원하지 않는다고 선언 |
| extended_agent_card=False | 확장 Agent Card 기능을 지원하지 않는다고 선언 |
현재 프로젝트는 일반적인 요청과 응답 중심으로 설계했으므로 간단한 기능만 선언하고 있습니다.
다만 streaming=False와 Manager 코드의 async for는 구분해서 이해해야 합니다. 비동기 반복문을 쓴다고 해서 서버가 반드시 스트리밍 기능을 지원한다는 뜻은 아닙니다. SDK가 단일 응답을 비동기 방식으로 전달할 수도 있기 때문입니다.
④ 최종 Agent Card 생성
card = AgentCard(
    name=name,
    description=description,
    version="1.0.0",
    supported_interfaces=[interface],
    capabilities=capabilities,
    skills=[skill],
    default_input_modes=["text/plain"],
    default_output_modes=["text/plain"],
)
앞에서 만든 Skill, Interface, Capabilities를 하나로 결합합니다.
default_input_modes와 default_output_modes는 기본 입출력 형식을 나타냅니다.
현재는 텍스트 기반으로 통신하므로 text/plain을 사용합니다.
마지막에:
return card생성한 Agent Card를 반환합니다.
4-3. 왜 공통 모듈로 만들었을까?
만약 이 함수를 만들지 않았다면 Weather, Research, Document Agent마다 Agent Card 생성 코드를 반복해서 작성해야 합니다.
그런데 공통 함수를 사용하면 각 에이전트는 자신에게 필요한 정보만 전달하면 됩니다.
이것은 소프트웨어 설계에서 다음 두 가지 원칙과 연결됩니다.
-
재사용성: 동일한 기능을 여러 곳에서 재사용
-
일관성: 모든 Agent Card가 같은 구조와 규칙을 사용
향후 에이전트가 3개에서 10개, 20개로 늘어나도 이 함수 하나를 통해 기본적인 Agent Card 구조를 통일할 수 있습니다.
5. Weather Agent: 날씨 전문 에이전트
이제 실제 원격 에이전트의 구조를 살펴보겠습니다.
Weather Agent는 세 부분으로 구성됩니다.
-
환경 설정
-
ADK Agent 정의
-
A2A 서버 생성
5-1. 환경 설정
PROJECT_ROOT = Path(__file__).resolve().parents[1]
ENV_FILE = PROJECT_ROOT / ".env"

load_dotenv(
    dotenv_path=ENV_FILE,
    override=True
)
이 부분은 앞에서 설명한 공통 환경 설정입니다.
현재 파일의 위치가 다음과 같기 때문입니다.
adk_2/remote_weather_agent/agent.py.parents[1]을 통해 adk_2로 올라가고, 그 아래의 .env를 찾습니다.
5-2. Agent Card 생성
custom_card = create_agent_card(
    name="AdvancedWeatherExpert",
    description=(
        "Google Search를 활용하여 국내외 여행지의 "
        "날씨와 기상 조건을 분석하는 전문 에이전트"
    ),
    skill_id="realtime_weather_lookup",
    skill_name="실시간 기상 분석",
    skill_description=(
        "여행지의 현재 날씨, 기온, 습도, 풍속, "
        "강수 확률 및 여행 기간의 예보를 조사합니다."
    ),
    tags=["weather","realtime","forecast","travel"],
    port=10000,
)
여기서 create_agent_card()는 앞서 설명한 공통 함수입니다.
Weather Agent는 자신을 다음과 같이 소개합니다.
-
이름: AdvancedWeatherExpert
-
전문 분야: 실시간 기상 분석
-
포트: 10000
-
주요 태그: weather, realtime, forecast, travel
이 Agent Card를 통해 원격 시스템은 Weather Agent가 날씨 관련 업무를 수행한다는 것을 파악할 수 있습니다.
5-3. Weather Agent 정의
weather_agent = Agent(
    model=os.getenv("GOOGLE_MODEL","gemini-3.5-flash"),
    name="weather_agent",
    description=(
        "실시간 검색을 통해 여행지의 날씨와 "
        "기상 정보를 조사하는 전문 에이전트"
    ),
    tools=[google_search],
    instruction=""" ... """
)
이 코드가 Weather Agent의 핵심입니다.
Agent()를 호출할 때 네 가지 요소를 전달합니다.
| 항목 | 역할 |
| model | 추론과 답변 생성에 사용할 Gemini 모델 |
| name | ADK 내부의 Agent 이름 |
| description | Agent의 역할 설명 |
| tools | Agent가 사용할 수 있는 외부 기능 |
| instruction | Agent가 어떤 방식으로 업무를 수행할지 지시 |
tools=[google_search]의 의미
이 부분이 매우 중요합니다.
tools=[google_search]Gemini 모델은 학습된 지식을 바탕으로 답변할 수 있지만, 여행 날짜의 날씨처럼 최신 정보가 필요한 업무에서는 외부 정보가 필요합니다.
Google Search Tool을 등록하면 모델은 필요할 때 검색을 활용할 수 있습니다.
다만 google_search를 등록했다고 해서 모든 질문에 무조건 검색하는 것은 아닙니다. 실제 사용 여부는 모델의 판단과 Agent Instruction에 영향을 받습니다.
Instruction을 자세히 이해하기
Weather Agent의 Instruction은 다음 업무를 지시합니다.
-
현재 날씨 조사
-
여행 기간의 예보 조사
-
기온, 습도, 풍속, 강수 확률 확인
-
비, 눈, 강풍 등 기상 조건 확인
-
적절한 옷차림 추천
-
우산, 방수용품 등 준비물 제안
여기서 좋은 부분은 미래 날씨를 임의로 만들어내지 말라는 규칙입니다.
예를 들어 6개월 뒤의 날씨를 질문했을 때 정확한 일별 예보가 존재하지 않는다면, AI가 그럴듯한 숫자를 만들어내면 안 됩니다.
현재 코드에는 다음과 같은 원칙이 있습니다.
-
실제 예보와 기후 평균을 구분
-
장기 예보가 없다면 계절별 기후를 설명
-
정보의 기준 날짜와 출처 URL 표시
-
확인되지 않은 정보는 확정적으로 표현하지 않음
이것은 여행 정보 서비스뿐 아니라 기업용 AI Agent를 만들 때도 중요한 설계 원칙입니다.
5-4. A2A 서버 생성
root_agent = weather_agent

a2a_app = to_a2a(
    root_agent,
    port=10000,
    agent_card=custom_card,
)
여기서 root_agent는 A2A 서버로 공개할 최상위 ADK Agent를 가리킵니다.
to_a2a()가 ADK Agent를 A2A 통신이 가능한 애플리케이션으로 변환합니다.
즉, 앞에서 만든 Weather Agent를 다른 에이전트가 네트워크를 통해 호출할 수 있게 하는 것입니다.
서버 실행 명령은 다음과 같습니다.
uvicorn remote_weather_agent.agent:a2a_app --host localhost --port 10000이 명령을 실행하면 Weather Agent가 10000번 포트에서 대기합니다.
핵심: Agent()는 AI 에이전트를 만들고, to_a2a()는 그 에이전트를 외부에서 호출할 수 있도록 공개합니다.
6. Research Agent: 여행 정보 전문 조사 에이전트
Research Agent도 Weather Agent와 기본적인 구조는 같습니다.
차이는 전문 분야와 Instruction입니다.
6-1. Agent Card
custom_card = create_agent_card(
    name="TravelResearchExpert",
    description=(
        "여행지의 관광 명소, 교통, 음식, "
        "여행 동선 및 관광 정보를 조사하는 전문 에이전트"
    ),
    skill_id="travel_destination_research",
    skill_name="여행지 전문 조사",
    skill_description=(
        "여행지의 주요 관광 명소, 추천 코스, "
        "교통, 음식, 관광 정보 및 여행 유의사항을 조사합니다."
    ),
    tags=["travel","research","tourism","attractions"],
    port=10001,
)
이 Agent Card는 Research Agent가 여행지 전문 조사 기능을 제공한다는 것을 나타냅니다.
Weather Agent와 달리 포트는 10001입니다.
6-2. Research Agent 생성
research_agent = Agent(
    model=os.getenv("GOOGLE_MODEL","gemini-3.5-flash"),
    name="research_agent",
    description=(
        "여행지의 관광 및 여행 정보를 전문적으로 조사하는 에이전트"
    ),
    tools=[google_search],
    instruction=""" ... """
)
여기서도 Google Search Tool을 사용합니다.
Research Agent의 조사 항목은 다음과 같습니다.
| 분야 | 조사 내용 |
| 관광 명소 | 주요 관광지 |
| 관광 코스 | 지역별 추천 코스 |
| 교통 | 이동 방법과 교통수단 |
| 음식 | 대표 음식과 식사 지역 |
| 활동 | 여행 기간에 적합한 체험 |
| 유의사항 | 관광지 이용 시 주의사항 |
| 실용 정보 | 여행에 필요한 현지 정보 |
6-3. Instruction에서 눈여겨볼 부분
현재 Research Agent의 지시문에는 다음과 같은 검색 효율 규칙이 있습니다.
관광지 5~7곳, 맛집 3~5곳 정도를 우선 조사한다.
불필요한 반복 검색을 하지 않는다.
확인되지 않은 가격, 영업시간은 추측하지 않는다.
이것은 단순한 문장처럼 보이지만, 실제로는 비용과 응답 시간을 관리하는 중요한 장치입니다.
왜냐하면 Google Search를 이용하는 에이전트가 검색을 지나치게 많이 하면 다음 문제가 생길 수 있기 때문입니다.
-
API 사용량 증가
-
전체 응답 시간 증가
-
중복 정보 증가
-
조사 결과가 지나치게 길어짐
-
Document Agent에 전달하는 입력 토큰 증가
따라서 에이전트의 전문성뿐 아니라 업무 범위도 제한하는 것이 중요합니다.
6-4. 서버 생성
root_agent = research_agent

a2a_app = to_a2a(
    root_agent,
    port=10001,
    agent_card=custom_card,
)
실행 명령:
uvicorn remote_research_agent.agent:a2a_app --host localhost --port 10001이제 Research Agent는 독립적으로 실행되는 서비스가 됩니다.
7. Document Agent: 최종 문서 생성 전문 에이전트
Document Agent는 단순히 답변을 작성하는 것이 아니라 실제 파일을 생성한다는 점에서 의미가 큽니다.
Weather와 Research가 정보를 수집하고, Document가 결과물을 만드는 구조입니다.
7-1. 보고서 저장 경로
BASE_DIR = Path(__file__).resolve().parents[1]

REPORT_DIR = BASE_DIR / "generated_reports"

REPORT_DIR.mkdir(
    parents=True,
    exist_ok=True
)
현재 파일은 다음 경로에 있습니다.
adk_2/remote_document_agent/agent.py따라서 parents[1]은 프로젝트 최상위인 adk_2입니다.
여기에 generated_reports를 붙여 보고서 저장 경로를 만듭니다.
mkdir()은 폴더를 생성하는 함수입니다.
-
parents=True: 상위 폴더도 필요하면 생성
-
exist_ok=True: 이미 존재해도 오류를 내지 않음
따라서 첫 실행 때 폴더가 없어도 자동으로 생성됩니다.
7-2. 사용자 정의 Python Tool: save_markdown_report()
이 함수가 Document Agent의 핵심입니다.
def save_markdown_report(
    title: str,
    markdown_content: str,
) -> dict:
이것은 일반적인 Python 함수입니다.
그런데 나중에 다음과 같이 ADK Agent의 tools에 등록하면 에이전트가 사용할 수 있는 Tool이 됩니다.
tools=[save_markdown_report]즉, AI 모델이 문서 내용을 작성하고, 실제 파일 저장은 Python 함수가 담당하는 구조입니다.
이것이 바로 LLM과 전통적인 프로그램 코드의 협업입니다.
① 파일명에 사용할 문자열 정리
safe_title = re.sub(
    r'[\\/:*?"<>|+]',
    "_",
    title,
).strip()
Windows 파일명에서 사용할 수 없거나 불편한 문자를 _로 바꿉니다.
예를 들어:
제주도 여행: 2박 3일 / 가족 여행이런 제목에서 :, / 등의 문자를 _로 바꿉니다.
② 제목 길이 제한
safe_title = safe_title[:60] or "travel_plan"파일명이 지나치게 길어지는 것을 방지합니다.
-
최대 60자 사용
-
제목이 비어 있으면 travel_plan 사용
③ 날짜와 시간 생성
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")현재 시각을 파일명에 사용할 문자열로 변환합니다.
예를 들어:
20261115_143025이렇게 하면 동일한 제목의 문서를 여러 번 저장해도 파일명이 겹칠 가능성이 줄어듭니다.
단, 초 단위까지 같으면 파일명이 중복될 수 있으므로 운영 환경에서는 UUID나 마이크로초를 추가하는 방법도 있습니다.
④ 파일명과 경로 생성
filename = f"{safe_title}_{timestamp}.md"

file_path = REPORT_DIR / filename
최종적으로 다음과 같은 경로가 만들어집니다.
adk_2/generated_reports/
제주도 여행_2박 3일_20261115_143025.md
⑤ 파일 저장
file_path.write_text(
    markdown_content,
    encoding="utf-8",
)
이 코드가 실제 파일을 생성합니다.
write_text()는 문자열을 파일에 기록하는 Python 기능입니다.
encoding="utf-8"은 한글이 깨지지 않도록 UTF-8로 저장하는 설정입니다.
⑥ 결과 반환
return {
    "status": "success",
    "message": "여행 계획서가 정상적으로 저장되었습니다.",
    "filename": filename,
    "file_path": str(file_path.resolve()),
    "format": "Markdown",
}
저장에 성공하면 딕셔너리를 반환합니다.
여기에는 다음 정보가 들어갑니다.
-
저장 성공 여부
-
성공 메시지
-
파일명
-
전체 경로
-
파일 형식
이 결과를 Document Agent가 읽고 Manager에게 반환할 수 있습니다.
이 설계의 중요한 의미
AI 모델은 문서를 작성하는 데 강점이 있지만, 로컬 파일 시스템에 직접 접근하는 것은 별도의 도구가 필요합니다.
여기서는 역할을 분리했습니다.
Gemini 모델
문서의 내용과 구성, 표, 일정 등을 작성합니다.
Python Tool
완성된 Markdown 문자열을 받아 실제 파일로 저장합니다.
파일 시스템
generated_reports에 .md 파일을 생성합니다.
이 방식은 여행 계획서뿐 아니라 제안서, 회의록, 업무 보고서, 계약서 초안 등 다양한 문서 자동화로 확장할 수 있습니다.
7-3. Document Agent의 Agent Card
custom_card = create_agent_card(
    name="TravelDocumentExpert",
    description=(
        "여행 조사 결과를 통합하여 "
        "체계적인 여행 계획서를 작성하고 저장하는 전문 에이전트"
    ),
    skill_id="travel_document_generation",
    skill_name="여행 계획서 생성",
    ...
    port=10002,
)
이 Agent Card는 문서 생성 기능을 공개합니다.
여기서 중요한 점은 Document Agent가 날씨 조사나 관광지 검색을 직접 담당하지 않는다는 것입니다.
Manager가 전달한 조사 결과를 통합해 문서로 만듭니다.
7-4. Document Agent 정의
document_agent = Agent(
    model=os.getenv("GOOGLE_MODEL","gemini-3.5-flash"),
    name="document_agent",
    description=(
        "전문 에이전트들의 조사 결과를 통합하여 "
        "여행 계획서를 작성하는 문서 생성 에이전트"
    ),
    tools=[save_markdown_report],
    instruction=""" ... """
)
Weather와 Research에는 google_search가 등록되어 있었지만, Document에는 다음 Tool이 등록되어 있습니다.
tools=[save_markdown_report]이 차이가 중요합니다.
-
Weather: 외부 정보 검색이 주된 도구
-
Research: 관광 정보 검색이 주된 도구
-
Document: 로컬 문서 저장이 주된 도구
각 에이전트가 필요한 기능만 갖도록 설계한 것입니다.
7-5. Document Agent의 문서 구성 지침
현재 Instruction은 다음과 같은 구조를 요구합니다.
-
여행 개요
-
여행지 날씨 분석
-
주요 관광 정보
-
추천 여행 일정
-
옷차림 및 준비물
-
교통 및 여행 유의사항
-
참고 자료 및 출처
이 구조는 좋은 출발점입니다.
특히 다음 규칙이 중요합니다.
전달받은 실제 조사 결과를 우선 사용한다.
조사되지 않은 내용을 사실처럼 작성하지 않는다.
불확실한 내용은 확인 필요로 표시한다.
이 규칙이 없다면 Document Agent가 조사 결과에 없는 내용을 그럴듯하게 추가할 수 있습니다.
즉, Document Agent는 정보를 새로 발명하는 에이전트가 아니라 검증된 조사 결과를 구조화하는 에이전트로 역할을 제한하는 것이 바람직합니다.
7-6. A2A 서버 생성
root_agent = document_agent

a2a_app = to_a2a(
    root_agent,
    port=10002,
    agent_card=custom_card,
)
실행 명령:
uvicorn remote_document_agent.agent:a2a_app --host localhost --port 10002이제 Document Agent도 독립 서버로 작동합니다.
8. 가장 중요한 부분: Manager Agent
이제 프로젝트의 핵심으로 들어가겠습니다. Manager Agent는 단순히 사용자 질문에 답하는 챗봇이 아닙니다. 세 개의 독립된 원격 에이전트에 일을 나누어 주고, 그 결과를 받아 최종 결과물까지 완성하는 오케스트레이터(Orchestrator)입니다.
이 프로젝트에서 가장 많은 설계 개념이 들어 있는 파일이 manager_agent/agent.py입니다.
전체적으로 다섯 부분으로 구성됩니다.
-
A2A 원격 호출 함수
-
원격 에이전트 주소
-
전체 여행 계획 생성 Tool
-
Manager Agent 정의
-
ADK 진입점
8-1. A2A 관련 라이브러리
import asyncio
import time
import traceback

from a2a.client.client_factory import ClientFactory
from a2a.client import ClientConfig, ClientCallContext
from a2a.helpers import new_text_message
from a2a.types import SendMessageRequest, Role
각각의 역할을 이해해 보겠습니다.
| 라이브러리 | 역할 |
| asyncio | 비동기 작업과 병렬 실행 |
| time | 실행 시간 측정 |
| traceback | 상세한 오류 발생 위치 출력 |
| ClientFactory | 원격 A2A Client 생성 |
| ClientConfig | Client 동작 설정 |
| ClientCallContext | 호출 시 전달할 문맥 및 요청 설정 |
| new_text_message | A2A 메시지 생성 |
| SendMessageRequest | 메시지 전송 요청 |
| Role | 메시지 발신자 역할 지정 |
특히 asyncio는 이번 프로젝트의 중요한 기술입니다.
Weather Agent와 Research Agent가 동시에 작업할 수 있도록 해주는 핵심 요소입니다.
8-2. extract_text(): A2A 응답에서 텍스트 추출
먼저 다음 함수를 보겠습니다.
def extract_text(data):
    """A2A 응답에서 텍스트를 추출한다.
    Task, Message, Artifact 등의 중첩 구조를 처리한다.
    """

    results = []

    def walk(value):
        if isinstance(value, str):
            return

        if isinstance(value, dict):
            text_value = value.get("text")

            if isinstance(text_value, str) and text_value.strip():
                results.append(text_value)

            for key, item in value.items():
                if key != "text":
                    walk(item)

        elif isinstance(value, list):
            for item in value:
                walk(item)

    walk(data)

    unique_results = list(dict.fromkeys(results))

    return "\n".join(unique_results)
이 함수는 A2A 응답에서 실제 텍스트만 추출하는 역할을 합니다.
왜 이런 함수가 필요할까요?
A2A 응답은 단순히 다음과 같은 문자열로만 오지 않을 수 있습니다.
제주도 날씨는 맑습니다.실제로는 메시지, Task, Artifact 등 여러 단계로 구성된 구조 안에 텍스트가 들어 있을 수 있습니다.
따라서 응답 객체를 그대로 출력하는 것만으로는 원하는 내용만 추출하기 어려울 수 있습니다.
① 결과를 담을 리스트
results = []추출한 텍스트를 저장할 리스트입니다.
② 내부 함수 walk()
def walk(value):이 함수는 중첩된 데이터 구조를 재귀적으로 탐색합니다.
재귀 함수란 함수가 자기 자신을 다시 호출하는 함수입니다.
예를 들어 다음과 같은 구조가 있다고 가정해 보겠습니다.
data = {
    "task": {
        "message": {
            "parts": [
                {"text": "제주도 날씨는 맑습니다."},
                {"text": "기온은 18도입니다."}
            ]
        }
    }
}
walk()는 딕셔너리 안의 딕셔너리, 리스트 안의 딕셔너리까지 계속 들어가면서 text 항목을 찾습니다.
③ 딕셔너리 탐색
if isinstance(value, dict):
	text_value = value.get("text")
isinstance()는 특정 객체가 지정한 자료형인지 확인하는 함수입니다.
여기서는 value가 딕셔너리인지 확인합니다.
if isinstance(text_value, str) and text_value.strip():
    results.append(text_value)
text가 문자열이고 공백만 있는 내용이 아니라면 리스트에 추가합니다.
④ 나머지 데이터 재귀 탐색
for key, item in value.items():
    if key != "text":
        walk(item)
현재 딕셔너리에서 text를 추출한 다음 다른 항목도 탐색합니다.
이 부분 때문에 여러 단계로 중첩된 데이터도 처리할 수 있습니다.
⑤ 리스트 탐색
elif isinstance(value, list):
    for item in value:
        walk(item)
리스트 안에 들어 있는 항목도 하나씩 다시 탐색합니다.
⑥ 중복 제거
unique_results = list(dict.fromkeys(results))중복된 텍스트를 제거합니다.
dict.fromkeys()는 순서를 유지하면서 중복 키를 제거하는 데 활용할 수 있습니다.
⑦ 최종 문자열 생성
return "\n".join(unique_results)여러 텍스트를 줄바꿈으로 연결합니다.
예를 들어 다음처럼 반환됩니다.
제주도 날씨는 맑습니다.
기온은 18도입니다.
바람은 약하게 불겠습니다.
설계상 주의할 점
현재 extract_text()는 JSON 형태의 dict와 list를 대상으로 작성되어 있습니다. 그래서 바로 다음의 response_to_text()가 A2A 응답 객체를 먼저 JSON 형태로 변환하는 구조입니다.
즉, 두 함수는 하나의 쌍으로 이해해야 합니다.
-
response_to_text(): 응답 객체를 다루기 쉬운 데이터로 변환
-
extract_text(): 변환된 데이터에서 텍스트 추출
8-3. response_to_text(): A2A 응답 객체 변환
def response_to_text(response):
    """A2A SDK 버전에 따른 응답 객체를
    JSON 형태로 변환한 후 텍스트를 추출한다.
    """

    if hasattr(response, "model_dump"):
        data = response.model_dump(
            mode="json",
            by_alias=True,
        )
    else:
        from google.protobuf.json_format import MessageToDict

        try:
            data = MessageToDict(
                response,
                preserving_proto_field_name=True,
            )
        except Exception:
            return str(response)

    text = extract_text(data)

    return text if text else str(response)
이 함수의 핵심은 응답 객체의 자료형 차이를 처리하는 것입니다.
A2A SDK나 내부 객체가 사용하는 모델에 따라 응답 객체가 Pydantic 기반일 수도 있고, Protocol Buffers 기반일 수도 있습니다.
① hasattr()
if hasattr(response, "model_dump"):hasattr()는 객체에 특정 속성이나 메서드가 존재하는지 확인합니다.
여기서는 model_dump라는 메서드가 있는지 확인합니다.
② Pydantic 객체라면
data = response.model_dump(
    mode="json",
    by_alias=True,
)
Pydantic 모델을 JSON으로 변환할 수 있는 Python 자료형으로 바꿉니다.
-
mode="json": JSON으로 직렬화할 수 있는 형태
-
by_alias=True: 별칭 필드명을 사용하도록 요청
이렇게 변환하면 extract_text()가 탐색하기 쉬워집니다.
③ Protocol Buffers 객체라면
from google.protobuf.json_format import MessageToDictProtocol Buffers는 데이터 구조를 효율적으로 직렬화하고 전달하기 위한 기술입니다.
MessageToDict()를 사용하면 Protocol Buffers 메시지를 딕셔너리 형태로 변환할 수 있습니다.
④ 변환 실패 시
except Exception:
	return str(response)
변환할 수 없다면 응답 객체를 문자열로 반환합니다.
⑤ 텍스트 추출
text = extract_text(data)

return text if text else str(response)
텍스트가 추출되면 텍스트를 반환하고, 그렇지 않으면 원래 응답의 문자열 표현을 반환합니다.
두 함수의 관계
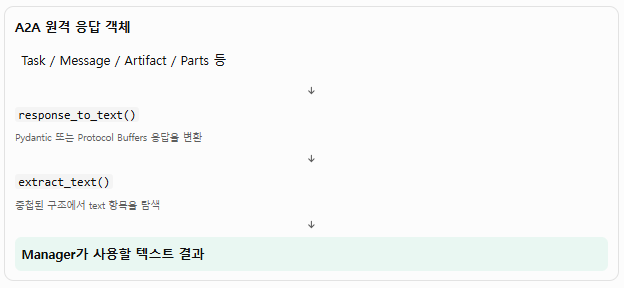
이 부분은 단순한 문자열 전달을 넘어, A2A 응답 데이터 구조를 이해하고 처리하려는 설계입니다.
8-4. 핵심 함수 call_remote_agent()
이 함수가 Manager Agent의 실제 통신 엔진입니다.
async def call_remote_agent(
    agent_name: str,
    agent_url: str,
    request_text: str,
    timeout_seconds: int = 240,
) -> str:
이 함수는 세 가지 정보를 전달받습니다.
| 인자 | 의미 |
| agent_name | 호출할 Agent 이름 |
| agent_url | 원격 Agent 주소 |
| request_text | 원격 Agent에게 보낼 요청 내용 |
| timeout_seconds | 응답 대기 제한 시간 |
반환값은 원격 Agent가 생성한 문자열입니다.
즉, Manager는 이 함수 하나로 Weather, Research, Document를 모두 호출할 수 있습니다.
① 실행 시간 측정
start_time = time.perf_counter()
client = None
stage = "시작"
time.perf_counter()는 실행 시간 측정에 적합한 고해상도 타이머입니다.
start_time은 전체 실행이 시작된 시점을 저장합니다.
client = None은 아직 Client가 생성되지 않았다는 뜻입니다.
stage는 오류가 발생한 단계를 기록하기 위한 변수입니다.
이렇게 하면 문제가 생겼을 때 단순히 "시간 초과"라고만 하지 않고 어느 단계에서 문제가 발생했는지 추적할 수 있습니다.
② Client 생성
factory = ClientFactory(
    config=ClientConfig(
        streaming=False,
        polling=False,
    )
)
여기서 ClientFactory를 생성합니다.
ClientConfig에는 현재 코드에서 스트리밍과 폴링을 사용하지 않도록 설정하고 있습니다.
이 프로젝트는 우선 일반적인 요청과 응답 방식으로 구성되어 있으므로 단순한 통신 구조를 선택한 것입니다.
이후:
client = await asyncio.wait_for(
    factory.create_from_url(agent_url),
    timeout=20,
)
이 부분은 원격 Agent의 Client를 만드는 작업입니다.
asyncio.wait_for()는 비동기 작업에 시간 제한을 적용합니다.
여기서는 Client 생성에 최대 20초를 허용합니다.
이 단계에는 원격 Agent의 주소와 Agent Card 확인 등 연결 준비 과정이 포함될 수 있습니다.
③ 요청 메시지 생성
client = await asyncio.wait_for(
    factory.create_from_url(agent_url),
    timeout=20,
)
이 부분은 앞의 test_a2a.py에서 설명한 것과 동일합니다.
다만 여기서는 테스트 문장이 아니라 실제 업무 요청을 전달합니다.
예를 들어 Weather Agent에게는 다음과 같은 내용이 전달됩니다.
제주도 2박 3일 여행 기간의 날씨를 조사해 줘.
기온, 강수, 풍속, 옷차림을 알려 줘.
④ 원격 Agent 응답 받기
async def receive_response():
    collected = []

    context = ClientCallContext(
        timeout=float(timeout_seconds)
    )

    async for event in client.send_message(
        request,
        context=context,
    ):
        ...
여기서는 내부 비동기 함수를 하나 더 정의합니다. 이 함수는 실제 메시지 전송과 응답 수집을 담당합니다. ClientCallContext는 요청에 관련된 호출 문맥을 전달합니다. 현재 코드는 timeout_seconds를 호출 제한 시간으로 전달하려고 설계했습니다.
다만 이 부분은 현재 설치된 A2A SDK의 API 시그니처와 반드시 일치해야 합니다. ClientConfig, ClientCallContext, send_message()의 인자 및 응답 방식은 버전에 따라 달라질 수 있습니다. 현재 코드가 실제 환경에서 정상 실행되는 조합이라면 그 버전을 고정해 두는 것이 좋습니다.
⑤ 응답 이벤트 수집
for event in ...실제 코드는 다음과 같이 비동기 반복문을 사용합니다.
async for event in client.send_message(
    request,
    context=context,
):
    print(
        f"[{agent_name}] A2A 응답 이벤트 수신: "
        f"{type(event).__name__}"
    )

    event_text = response_to_text(event)

    if event_text:
        collected.append(event_text)
여기서 각 응답 이벤트의 자료형을 출력하고, response_to_text()를 통해 텍스트를 추출합니다.
텍스트가 존재하면 collected 리스트에 추가합니다.
이렇게 하는 이유는 응답이 여러 이벤트로 전달되는 상황을 처리하기 위해서입니다.
⑥ 응답 결과 통합
return "\n".join(collected)수집한 응답을 하나의 문자열로 합칩니다.
⑦ 전체 응답 대기 시간 제한
result = await asyncio.wait_for(
    receive_response(),
    timeout=timeout_seconds + 10,
)
현재 코드에서는 내부의 ClientCallContext에 240초를 전달하고, 바깥의 asyncio.wait_for()에는 250초를 적용합니다.
왜 10초를 더했을까요?
내부 호출의 시간 제한과 바깥의 전체 대기 제한이 거의 동시에 끝나는 상황에서 외부 제한이 먼저 걸리는 것을 피하려는 의도로 볼 수 있습니다.
⑧ 빈 응답 확인
if not result or not result.strip():
    raise RuntimeError(
        f"{agent_name}: 응답 텍스트가 비어 있습니다."
    )
통신은 성공했더라도 실제 텍스트가 없을 수 있습니다.
이 경우 정상적인 업무 결과가 아니므로 예외를 발생시킵니다.
⑨ 오류 처리
except asyncio.TimeoutError:시간 초과가 발생한 경우 별도로 처리합니다.
error_message = (
    f"{agent_name} 시간 초과: "
    f"단계={stage}, "
    f"경과시간={elapsed:.1f}초, "
    f"제한시간={timeout_seconds}초"
)
이렇게 하면 어느 Agent에서 어느 단계까지 진행했는지 확인할 수 있습니다.
일반 오류는 다음 구문에서 처리합니다.
except Exception as e:오류 유형, 메시지, 경과 시간을 출력하고:
traceback.print_exc()상세한 오류 발생 위치까지 출력합니다.
⑩ Client 정리
finally:
    if client is not None:
        await client.close()
마지막에는 Client를 닫습니다.
이 함수의 구조를 한눈에 정리하면 다음과 같습니다.
call_remote_agent() 실행 순서
-
원격 Agent 이름과 URL을 전달받음
-
A2A Client 생성 및 연결 준비
-
요청 메시지와 요청 객체 생성
-
원격 Agent에 메시지 전송
-
응답 이벤트 수신
-
응답 객체를 텍스트로 변환
-
응답을 하나의 문자열로 통합
-
시간 초과 및 예외 처리
-
Client 연결 정리
이 함수가 있기 때문에 Manager는 세 개의 원격 Agent를 같은 방식으로 호출할 수 있습니다.
9. Manager의 원격 에이전트 주소
WEATHER_AGENT_URL = "http://localhost:10000/"
RESEARCH_AGENT_URL = "http://localhost:10001/"
DOCUMENT_AGENT_URL = "http://localhost:10002/"
이 세 개의 상수는 Manager가 호출할 원격 Agent의 주소입니다.
여기서 중요한 설계 포인트는 원격 Agent의 주소를 코드의 여러 곳에 직접 반복하지 않고 한 곳에 모아 둔 것입니다.
향후 원격 서버가 다른 컴퓨터로 이동한다면 이 주소만 바꾸면 됩니다.
실제 운영 환경에서는 이 주소들을 .env로 옮겨 다음처럼 관리하는 것이 더 좋습니다.
WEATHER_AGENT_URL=http://localhost:10000/
RESEARCH_AGENT_URL=http://localhost:10001/
DOCUMENT_AGENT_URL=http://localhost:10002/
그러면 개발·테스트·운영 환경에 따라 주소를 쉽게 변경할 수 있습니다.
10. create_complete_travel_plan(): 전체 여행 계획을 생성하는 핵심 Tool
이 함수는 프로젝트의 실질적인 오케스트레이션 로직입니다.
다시 말하면 세 개의 전문 에이전트를 호출하고, 결과를 모아 문서 생성까지 연결하는 함수입니다.
async def create_complete_travel_plan(
    destination: str,
    travel_period: str,
    travelers: int = 1,
    interests: str = "일반 관광",
    budget: str = "보통",
) -> dict:
입력값은 다음과 같습니다.
| 인자 | 의미 | 기본값 |
| destination | 여행 목적지 | 필수 |
| travel_period | 여행 기간 | 필수 |
| travelers | 여행 인원 | 1명 |
| interests | 관심사 | 일반 관광 |
| budget | 예산 수준 | 보통 |
예를 들어 사용자가 다음과 같이 요청했다고 가정해 보겠습니다.
제주도 2박 3일 여행 계획을 만들어 줘.
인원은 2명이고, 자연경관과 맛집을 좋아해.
예산은 보통 수준이야.
그러면 Manager는 다음과 같은 값을 함수에 전달합니다.
destination = "제주도"
travel_period = "2박 3일"
travelers = 2
interests = "자연경관과 맛집"
budget = "보통"
10-1. Weather Agent에게 전달할 요청 만들기
weather_request = f"""다음 여행에 대한 날씨 정보를 조사해.

여행 목적지: {destination}
여행 기간: {travel_period}
여행 인원: {travelers}명

조사 항목:
- 현재 날씨
- 여행 기간의 일기 예보
- 기온, 습도, 풍속, 강수 확률
- 여행에 영향을 줄 기상 조건
- 적합한 옷차림 및 준비물
...
"""
이 부분은 Weather Agent에 전달할 업무 지시문을 만드는 과정입니다.
f""" ... """는 Python의 f-string입니다.
중괄호 {destination} 등에 변수값이 들어갑니다.
즉, 사용자의 입력값을 반영해 실제 요청 메시지를 동적으로 만드는 것입니다.
10-2. Research Agent에게 전달할 요청 만들기
research_request = f"""다음 여행에 대한 전문 조사를 수행해.

여행 목적지: {destination}
여행 기간: {travel_period}
여행 인원: {travelers}명
관심사: {interests}
예산: {budget}

조사 항목:
- 주요 관광 명소
- 추천 관광 코스
- 지역별 이동 동선
- 교통 정보
- 음식 및 식사 정보
- 여행 시 유의사항
...
"""
Research Agent에는 관심사와 예산까지 전달합니다.
Weather Agent와 Research Agent가 받는 정보가 다른 이유는 담당 업무가 다르기 때문입니다.
-
Weather는 날씨 조사에 필요한 목적지와 기간이 핵심
-
Research는 관심사와 예산도 중요
이것은 각 전문 에이전트에 필요한 정보만 전달하는 설계입니다.
10-3. Weather와 Research를 병렬 실행
이제 가장 중요한 부분입니다.
weather_task = call_remote_agent(
    agent_name="Weather Agent",
    agent_url=WEATHER_AGENT_URL,
    request_text=weather_request,
    timeout_seconds=240,
)
research_task = call_remote_agent(
agent_name="Research Agent",
agent_url=RESEARCH_AGENT_URL,
request_text=research_request,
timeout_seconds=240,
)여기서 두 함수를 호출했지만 아직 await를 하지 않았습니다.
따라서 이 시점에는 비동기 코루틴 객체를 만들었다고 이해하면 됩니다.
그다음:
results = await asyncio.gather(
    weather_task,
    research_task,
    return_exceptions=True,
)
이 코드가 두 작업을 동시에 진행합니다.
순차 실행과 병렬 실행 비교
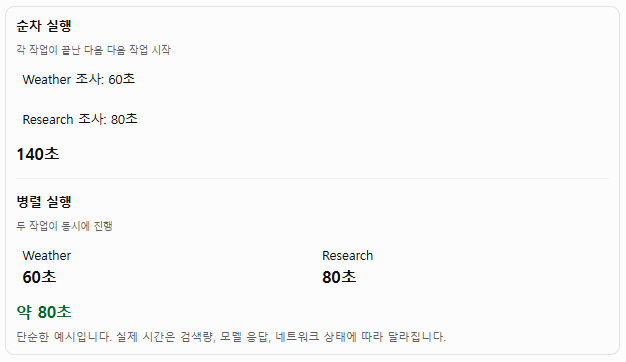
즉, 병렬 실행에서는 두 작업 중 더 오래 걸리는 작업의 시간에 가까워집니다.
현재 코드에서 이 부분은 다음과 같습니다.
results = await asyncio.gather(
    weather_task,
    research_task,
    return_exceptions=True,
)
asyncio.gather()는 여러 비동기 작업을 함께 실행하고 결과를 모읍니다.
return_exceptions=True가 특히 중요합니다.
이 옵션이 없으면 한 작업에서 예외가 발생할 때 전체 gather()가 예외를 발생시킬 수 있습니다.
반면 return_exceptions=True를 사용하면 실패한 작업의 예외도 결과 리스트에 포함됩니다.
예를 들어:
results = [
    "제주도 날씨는 ...",
    TimeoutError("Research Agent 시간 초과")
]
이런 형태가 될 수 있습니다.
병렬 실행을 이해할 때의 중요한 구분
asyncio.gather()를 사용한다고 해서 Python 코드가 반드시 여러 CPU 코어에서 동시에 실행된다는 뜻은 아닙니다.
이 경우에는 주로 네트워크 요청과 외부 API 응답을 기다리는 시간을 겹치게 하는 비동기 I/O 병렬성입니다.
AI Agent 시스템에서는 이러한 방식이 매우 유용합니다.
10-4. 개별 에이전트 실패 처리
weather_result = results[0]
research_result = results[1]
첫 번째 결과는 Weather, 두 번째 결과는 Research입니다.
이후 다음 코드를 실행합니다.
if isinstance(weather_result, Exception):
    weather_result = (
        f"Weather Agent 호출 실패: {weather_result}"
    )

if isinstance(research_result, Exception):
    research_result = (
        f"Research Agent 호출 실패: {research_result}"
    )
여기서 isinstance()로 결과가 정상 문자열인지, 예외 객체인지 확인합니다.
실패한 경우에는 예외를 문자열로 바꿉니다.
이렇게 하면 Document Agent에 두 결과를 모두 전달할 수 있습니다.
예를 들어 Weather는 성공했지만 Research가 실패했다면:
Weather Agent 결과:
제주도 날씨는 ...

Research Agent 결과:
Research Agent 호출 실패: ...
이렇게 됩니다.
이 설계는 전체 시스템이 한 번의 실패로 완전히 중단되는 것을 방지한다는 장점이 있습니다.
10-5. Document Agent에 전달할 통합 요청 만들기
document_request = f"""다음 정보를 바탕으로 종합 여행 계획서를 작성해.

[여행 기본 정보]
목적지: {destination}
여행 기간: {travel_period}
여행 인원: {travelers}명
관심사: {interests}
예산: {budget}

[Weather Agent 조사 결과]
{weather_result}

[Research Agent 조사 결과]
{research_result}

위 두 전문 에이전트의 조사 결과를 통합하여
완성도 높은 여행 계획서를 작성해.
...
"""
이 부분은 Manager의 가장 중요한 역할을 보여줍니다. Manager는 단순히 세 Agent를 호출하는 데서 끝나지 않습니다. 두 Agent의 결과를 모아 세 번째 Agent가 이해할 수 있는 새로운 요청으로 구성합니다. 이것을 결과 통합 및 업무 인계(Handoff)라고 볼 수 있습니다.
여기서 Document Agent는 원래 Weather Agent나 Research Agent가 어떤 과정을 거쳐 조사했는지 알 필요가 없습니다. Manager가 정리해서 전달한 조사 결과만 받으면 됩니다. 이 구조가 좋은 이유는 각 에이전트의 결합도를 낮추기 때문입니다.
10-6. Document Agent 호출
try:
    document_result = await call_remote_agent(
        agent_name="Document Agent",
        agent_url=DOCUMENT_AGENT_URL,
        request_text=document_request,
        timeout_seconds=240,
    )

    document_ok = True

except Exception as e:
    document_ok = False

    document_result = (
        f"문서 생성 실패: {type(e).__name__}: {e}"
    )
여기서는 Document Agent를 호출합니다.
Weather와 Research는 병렬로 실행했지만, Document는 그 결과를 받아야 하므로 이후에 실행합니다.
즉, 전체 업무 흐름은 다음과 같습니다.
Weather ─────┐
             ├── 결과 통합 ── Document
Research ────┘
이것은 단순한 병렬 구조가 아니라 병렬 처리 후 순차 처리 구조입니다.
이런 설계를 Fan-out / Fan-in 패턴이라고 부르기도 합니다.
-
Fan-out: 하나의 요청을 여러 작업으로 분배
-
Fan-in: 여러 작업의 결과를 다시 모음
현재 프로젝트는 이 패턴을 잘 보여주는 예제입니다.
10-7. 최종 결과 반환
return {
    "status": "success" if document_ok else "partial_success",

    "travel_info": {
        "destination": destination,
        "travel_period": travel_period,
        "travelers": travelers,
        "interests": interests,
        "budget": budget,
    },

    "weather_result": weather_result,
    "research_result": research_result,
    "document_result": document_result,
}
마지막으로 Manager는 전체 결과를 딕셔너리로 반환합니다.
여기에는 다음 정보가 들어갑니다.
-
여행 기본 정보
-
Weather Agent 결과
-
Research Agent 결과
-
Document Agent 결과
-
전체 작업 상태
현재 코드의 개선 포인트: status 판정
현재는 다음과 같이 작성되어 있습니다.
"status": "success" if document_ok else "partial_success"즉, Document Agent만 성공하면 success가 됩니다.
그런데 Weather와 Research가 모두 실패하고 Document가 실패 메시지를 입력으로 받아 빈약한 문서를 만들어도 success가 될 수 있습니다. 이것은 업무 성공 판정으로는 다소 느슨합니다.
더 좋은 기준은 다음과 같습니다.
| 상황 | 권장 상태 |
| Weather, Research, Document 모두 성공 | success |
| 조사 중 일부 실패했지만 문서 생성 성공 | partial_success |
| Document 생성 실패 | failed 또는 partial_success |
| 필수 조사와 문서 생성 모두 실패 | failed |
즉, 전체 성공 여부는 document_ok만으로 결정하지 말고 Weather와 Research의 성공 여부도 함께 고려하는 편이 좋습니다.
예를 들어 아래처럼 바꿀 수 있습니다.
weather_ok = not isinstance(results[0], Exception)
research_ok = not isinstance(results[1], Exception)

if weather_ok and research_ok and document_ok:
    status = "success"
elif document_ok:
    status = "partial_success"
else:
    status = "failed"
다만 이 코드를 적용하려면 weather_result, research_result를 문자열로 바꾸기 전에 성공 여부를 별도로 저장해야 합니다.
11. Manager Agent 자체의 정의
앞의 create_complete_travel_plan()은 실제 업무를 수행하는 Python 함수입니다.
이제 이 함수를 Manager Agent가 사용할 수 있도록 등록해야 합니다.
11-1. ADK Agent 생성
from google.adk import Agent

manager_agent = Agent(
    model=os.getenv("GOOGLE_MODEL","gemini-3.5-flash"),
    name="travel_manager",
    description="""세 개의 원격 전문 에이전트를 관리하여
    종합 여행 계획서를 생성하는 Manager Agent.
    """,
    instruction=""" ... """,
    tools=[create_complete_travel_plan],
)
여기서 중요한 부분은 다음입니다.
tools=[create_complete_travel_plan]앞서 만든 Python 함수를 Manager Agent의 Tool로 등록한 것입니다.
이제 사용자가 여행 계획을 요청하면 Manager Agent는 Instruction에 따라 이 함수를 호출할 수 있습니다.
즉, 이 구조는 다음과 같습니다.
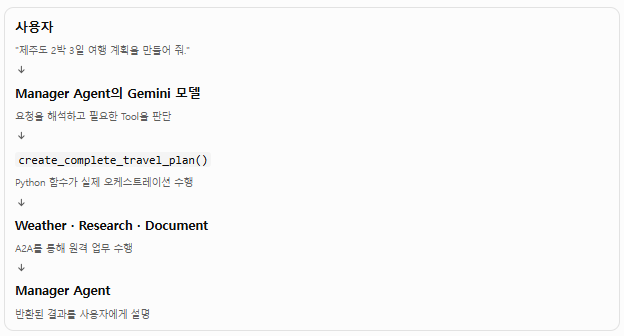
이것은 ADK에서 매우 중요한 개념인 Agent와 Tool의 역할 분리를 보여줍니다.
-
Agent: 어떤 일을 해야 하는지 판단하고 사용자와 대화
-
Tool: 실제로 정해진 작업을 수행하는 기능
여기서 Manager Agent는 Gemini 모델을 사용해 사용자 요청을 이해하고, Python Tool은 실제 원격 호출을 수행합니다.
11-2. Manager Instruction
현재 Instruction은 다음과 같은 역할을 지정합니다.
너는 Multi-Agent Travel Planner의 총괄 매니저야.

너는 직접 날씨나 관광 정보를 조사하지 않는다.

대신 다음 세 전문 에이전트의 업무를 관리한다.
...
이것은 좋은 설계입니다.
Manager가 직접 날씨와 관광지를 조사하기 시작하면 전문 에이전트의 역할이 불분명해집니다.
현재는 Manager의 업무를 명확히 제한하고 있습니다.
업무 수행 규칙
-
사용자 요청에서 목적지, 기간, 인원, 관심사, 예산 파악
-
목적지나 기간이 없으면 질문
-
필수 정보가 있으면 create_complete_travel_plan 호출
-
반환된 결과를 간결하게 요약
-
저장 경로 안내
-
일부 실패가 있으면 성공·실패 항목 구분
-
확인되지 않은 사실은 만들지 않음
여기서 특히 2번과 3번이 중요합니다.
사용자가 다음처럼 말할 수 있습니다.
제주도 여행 계획 만들어 줘.이 경우 여행 기간이 없습니다.
Manager는 먼저 기간을 질문해야 합니다.
반면 다음처럼 말한다면:
제주도 2박 3일 여행 계획을 만들어 줘.필수 정보가 있으므로 Tool을 호출해야 합니다.
이것은 대화형 Agent가 사용자 요청을 처리하는 기본 패턴입니다.
11-3. ADK 진입점
root_agent = manager_agent이 코드는 ADK가 사용할 최상위 Agent를 지정합니다.
원격 서버 세 개는 각각 to_a2a()로 A2A 애플리케이션을 만들었지만, Manager는 ADK Web에서 직접 사용할 Agent입니다.
따라서 Manager는 root_agent로 공개합니다.
다음 명령으로 실행합니다.
adk web --port 8000ADK Web 화면에서 manager_agent를 선택하면 사용자와 Manager Agent가 대화할 수 있습니다.
여기서 포트 8000은 Manager의 ADK Web 인터페이스이고, 10000~10002는 세 원격 에이전트의 A2A 서버입니다.
12. 전체 실행 방법과 실제 동작 순서
이제 코드를 이해했으니 실제 실행 순서를 정리해 보겠습니다.
현재 구조에서는 세 원격 Agent 서버를 먼저 실행하고, 마지막에 Manager를 실행해야 합니다.
12-1. 실행 전 준비
PowerShell을 열고 프로젝트 폴더로 이동합니다.
cd C:\Dev\book_agentic_ai\adk_2가상환경을 활성화합니다.
.\venv\Scripts\Activate.ps1가상환경 이름이 다르다면 실제 사용하는 경로에 맞추면 됩니다.
패키지 설치 상태를 확인합니다.
python -m pip check오류가 없다면 현재 설치된 패키지 간 의존성 충돌이 없는 것입니다.
12-2. 서버 실행 순서
서버마다 PowerShell 창을 하나씩 열어 실행하는 것이 가장 이해하기 쉽습니다.
터미널 1: Weather Agent 10000
uvicorn remote_weather_agent.agent:a2a_app --host localhost --port 10000
터미널 2: Research Agent 10001
uvicorn remote_research_agent.agent:a2a_app --host localhost --port 10001
터미널 3: Document Agent 10002
uvicorn remote_document_agent.agent:a2a_app --host localhost --port 10002
터미널 4: Manager Agent 8000
adk web --port 8000이제 브라우저에서 ADK Web 화면을 열고 manager_agent를 선택하면 됩니다.
12-3. 실제 여행 요청을 입력하면 어떤 일이 일어날까?
예를 들어 다음 요청을 입력합니다.
제주도 2박 3일 여행 계획을 만들어 줘.

여행 인원은 2명이고,
자연경관과 맛집을 중심으로 여행하고 싶어.
예산은 보통 수준으로 해 줘.
실제 내부 동작은 다음과 같습니다.
-
사용자 요청 접수
ADK Web → Manager Agent
Manager가 목적지, 기간, 인원, 관심사, 예산을 파악합니다.
-
업무 분배
Manager → Python Tool
create_complete_travel_plan()이 호출됩니다.
-
날씨 및 관광 정보 조사
Weather + Research 병렬 실행
두 Agent가 각각 Google Search를 활용해 조사합니다.
-
조사 결과 수집
A2A 응답 → Manager
Manager가 두 결과를 문자열로 정리합니다.
-
문서 작성 요청
Manager → Document Agent
두 조사 결과와 여행 기본 정보를 전달합니다.
-
Markdown 생성 및 저장
Document Agent → Python 저장 Tool
save_markdown_report()가 파일을 저장합니다.
-
최종 결과 전달
Document → Manager → 사용자
저장된 파일명과 경로를 포함한 결과를 반환합니다.
이 과정을 통해 사용자는 한 번의 요청으로 세 개의 전문 에이전트가 협력한 결과를 얻습니다.
13. 이 프로젝트에서 반드시 이해해야 할 핵심 기술 7가지
이제 조금 더 깊이 들어가 보겠습니다.
지금까지 작성한 코드를 이해하는 것과 이 프로젝트의 설계 원리를 이해하는 것은 다릅니다. 아래 일곱 가지를 이해하면 앞으로 훨씬 복잡한 멀티 에이전트 시스템을 설계할 수 있습니다.
13-1. ADK와 A2A는 서로 다른 역할이다
이 둘을 혼동하지 않는 것이 가장 중요합니다.
| 구분 | Google ADK | A2A |
| 핵심 역할 | Agent를 만들고 실행 | Agent끼리 통신 |
| 주요 기능 | 모델, Instruction, Tool | Agent Card, Message, Task |
| 현재 프로젝트 | 네 개 Agent 구현 | 세 원격 Agent 연결 |
| 비유 | 전문 직원을 채용하고 업무를 부여 | 회사 간 업무 전달 규약 |
쉽게 설명하겠습니다.
ADK는 직원 자체를 만드는 도구입니다.
A2A는 그 직원이 다른 회사의 직원과 협력할 수 있도록 해주는 통신 규약입니다.
이번 프로젝트에서는 ADK로 네 개의 Agent를 만들고, 그중 세 개를 A2A 서버로 공개했습니다.
13-2. Agent와 Tool은 다르다
이것도 매우 중요합니다.
예를 들어 Document Agent는 다음과 같이 만들어졌습니다.
document_agent = Agent(
    model=...,
    name="document_agent",
    tools=[save_markdown_report],
    instruction="..."
)
여기서:
-
document_agent: 판단하고 문서를 작성하는 AI Agent
-
save_markdown_report: 실제 파일을 저장하는 Python Tool
AI가 Markdown 내용을 작성하고, Python Tool이 파일을 저장합니다.
AI가 모든 일을 직접 처리하는 것이 아니라 AI의 판단과 일반 프로그램의 실행 기능을 결합한 구조입니다.
이 원리는 실제 업무 자동화에서 매우 중요합니다.
13-3. Agent Card와 Agent Instruction은 다르다
둘 다 설명처럼 보이지만 역할은 다릅니다.
| 구분 | Agent Card | Instruction |
| 목적 | 외부에 자신을 소개 | Agent의 행동을 지시 |
| 대상 | 다른 Agent와 A2A Client | 해당 Agent의 모델 |
| 내용 | 이름, Skill, URL, Capability | 역할, 업무 순서, 원칙 |
| 예시 | "나는 날씨 전문 Agent다" | "날씨를 검색하고 기온과 강수량을 정리해라" |
즉, Agent Card는 명함이고 Instruction은 업무 매뉴얼입니다.
13-4. 비동기와 병렬 실행
현재 코드에서 가장 중요한 Python 기술입니다.
async def call_remote_agent(...):async는 비동기 함수를 정의합니다.
await call_remote_agent(...)await는 비동기 작업의 결과를 기다립니다.
await asyncio.gather(...)여러 비동기 작업을 함께 실행하고 결과를 수집합니다.
이번 프로젝트에서는 Weather와 Research를 병렬로 실행하기 위해 사용합니다.
이것은 향후 다음과 같은 업무에도 적용할 수 있습니다.
-
여러 데이터 소스 동시 조회
-
여러 문서 동시 분석
-
여러 검색 Agent 동시 실행
-
여러 기업의 재무 데이터 동시 수집
13-5. Timeout과 예외 처리
현재 코드는 240초의 제한을 사용합니다.
timeout_seconds=240그리고:
await asyncio.wait_for(
    receive_response(),
    timeout=timeout_seconds + 10,
)
이렇게 해서 무한정 기다리지 않도록 설계했습니다.
이것은 중요합니다.
원격 Agent가 응답하지 않거나 외부 API가 지연되면 Manager가 계속 대기할 수 있기 때문입니다.
다만 Timeout은 원인을 해결하는 기능이 아니라, 일정 시간 이후 대기를 중단하는 기능입니다.
따라서 실무에서는 다음을 구분해서 로그를 남겨야 합니다.
-
Agent Card 조회 실패
-
Client 생성 실패
-
메시지 전송 실패
-
Gemini 모델 응답 지연
-
Google Search 지연
-
Document Tool 실행 실패
-
응답 변환 실패
현재 stage와 time.perf_counter()를 사용한 것은 이러한 진단을 위한 좋은 출발점입니다.
13-6. Fan-out / Fan-in 구조
현재 Manager의 작업 흐름은 전형적인 Fan-out / Fan-in 패턴입니다.

하나의 업무를 여러 전문 Agent에 분배한 후 다시 통합하는 방식입니다.
이 구조는 여행 계획뿐 아니라 기업의 업무 자동화에도 매우 적합합니다.
13-7. 원격 Agent는 독립적으로 확장할 수 있다
현재는 모든 서버가 같은 컴퓨터에서 실행됩니다.
하지만 A2A 구조에서는 원격 Agent를 별도의 서버로 이전할 수 있습니다.
예를 들어:
Manager Agent: Google Cloud Run
Weather Agent: Google Cloud Run
Research Agent: 별도 VM
Document Agent: 사내 문서 서버
이렇게 구성할 수 있습니다.
Manager는 각 Agent의 주소만 알면 되므로 내부 구현이 달라도 협업할 수 있습니다.
이것이 분산형 Agent 아키텍처의 중요한 장점입니다.
14. 현재 코드의 강점과 보완해야 할 부분
전체적으로 좋은 학습 구조입니다. 다만 실제 서비스로 발전시키려면 몇 가지를 보완하는 것이 좋습니다.
14-1. 현재 구조에서 잘 설계된 부분
| 설계 요소 | 평가 | 이유 |
| Agent별 폴더 분리 | 좋음 | 독립 개발과 유지보수에 유리 |
| 공통 Agent Card | 좋음 | 코드 중복과 불일치 감소 |
| 전문 Agent 역할 분리 | 좋음 | 업무별 책임이 명확 |
| A2A 서버 독립 실행 | 좋음 | 서버 분리와 확장에 유리 |
| Weather·Research 병렬 실행 | 좋음 | 외부 API 대기 시간 절약 |
| Timeout 설정 | 좋음 | 무한 대기 방지 |
| 예외 처리 | 좋음 | 일부 실패에도 결과 통합 가능 |
| 사용자 정의 저장 Tool | 좋음 | AI 작성 결과를 실제 파일로 변환 |
14-2. 반드시 개선할 사항
① 중복된 .env 로딩 제거
앞서 설명한 것처럼 명시적인 .env 로딩 후 다시 load_dotenv(override=True)를 호출하는 부분은 제거하는 것이 좋습니다.
각 Agent에서 프로젝트 최상위 .env만 일관되게 사용하도록 해야 합니다.
② 전체 성공 상태 판정 개선
현재는 Document Agent의 성공 여부만으로 전체 상태를 결정합니다.
Weather와 Research의 성공 여부도 별도로 저장해 전체 상태를 판단하는 것이 좋습니다.
③ 원격 Agent 주소를 환경변수로 분리
현재 Manager 코드에 주소가 직접 적혀 있습니다.
WEATHER_AGENT_URL = "http://localhost:10000/"운영 환경으로 이전할 때를 고려하면 .env로 분리하는 것이 좋습니다.
④ 시간 제한을 설정으로 관리
현재 240초가 코드에 직접 들어 있습니다.
timeout_seconds=240이를 환경변수로 관리하면 Agent별로 응답 제한을 조정하기 편합니다.
예를 들어:
WEATHER_TIMEOUT=240
RESEARCH_TIMEOUT=240
DOCUMENT_TIMEOUT=240
⑤ Document 저장 Tool의 오류 처리
현재 저장 함수는 파일 쓰기가 성공하면 성공 딕셔너리를 반환합니다.
운영 환경에서는 저장 과정의 예외도 명시적으로 처리하고, 실패 원인을 Manager에게 전달하도록 하는 것이 좋습니다.
또한 현재 파일명은 초 단위 시각을 사용하므로 동일한 초에 같은 제목의 파일이 생성될 가능성을 고려해 UUID 등을 추가할 수 있습니다.
⑥ A2A SDK 버전 고정
특히 다음 코드가 중요합니다.
from a2a.client import ClientConfig, ClientCallContext그리고:
client.send_message(
    request,
    context=context,
)
이 호출 방식은 설치된 A2A SDK의 실제 API와 일치해야 합니다.
따라서 정상 실행이 확인된 a2a-sdk 버전을 requirements.txt에 고정하는 것을 권합니다.
현재 코드가 작동하는 환경에서는 무작정 SDK를 업그레이드하지 않는 것이 좋습니다.
⑦ 검색 결과의 신뢰성 강화
현재 Google Search를 이용해 정보를 검색하지만, 검색 결과가 항상 정확한 것은 아닙니다.
실제 여행 서비스로 발전시킨다면 다음 원칙을 추가해야 합니다.
-
공식 관광 사이트 우선
-
기상청 등 공식 기상 정보 우선
-
가격과 영업시간은 조회 기준 시각 기록
-
검색 결과의 출처 URL 보존
-
날짜별 예보가 제공되지 않으면 명확히 표시
15. 이 프로젝트에서 한 단계 더 발전시키면 좋은 방향
이 부분이 특히 중요하다고 생각합니다.
현재 프로젝트는 멀티 에이전트 시스템의 기본 구조를 잘 갖추고 있습니다. 이제 단순한 여행 계획 생성에서 벗어나 기업용 AI 업무 플랫폼의 기본 구조로 발전시킬 수 있습니다.
15-1. 현재 2.0에서 3.0으로 발전하는 로드맵
Multi-Agent Travel Planner 2.0
-
Weather Agent
-
Research Agent
-
Document Agent
-
Manager Agent
-
A2A 통신 및 Markdown 생성
3.0: 지능형 오케스트레이션
-
작업 상태 추적
-
재시도 및 장애 복구
-
구조화된 Agent 결과
-
Agent별 실행 로그
-
결과 검증 및 품질 평가
4.0: 기업형 멀티 에이전트
-
사용자별 장기 기억
-
PostgreSQL 기반 업무 이력
-
GCS 기반 문서 저장
-
인증 및 권한 관리
-
중앙집중형 모니터링
5.0: Agent 서비스 플랫폼
-
Agent Registry
-
동적 Agent 발견
-
다중 사용자 및 조직 관리
-
웹 UI 및 API
-
비용·성능·품질 대시보드
15-2. 추가하면 좋은 전문 에이전트
현재 세 개의 전문 에이전트 외에도 다음과 같은 에이전트를 추가할 수 있습니다.
| 추가 Agent | 역할 |
| Budget Agent | 여행 비용 계산 및 예산 최적화 |
| Transportation Agent | 렌터카·대중교통·이동 시간 분석 |
| Reservation Agent | 숙소·식당 예약 지원 |
| Safety Agent | 기상특보·안전 위험 분석 |
| Review Agent | 여행 계획서 품질 및 사실 검증 |
| Translation Agent | 해외 여행지 다국어 정보 처리 |
특히 Review Agent를 추가하는 것을 추천합니다.
예를 들어 Document Agent가 작성한 여행 계획서를 Review Agent가 다시 검토합니다.
-
실제 존재하지 않는 관광지가 포함되었는가?
-
이동 동선이 비현실적인가?
-
날씨 정보와 일정이 서로 모순되는가?
-
출처가 빠진 정보가 있는가?
-
여행 기간과 날짜가 맞는가?
이렇게 하면 단순한 문서 생성에서 검증을 포함한 Agent Workflow로 발전합니다.
15-3. 여행 계획서 외의 기업 업무 활용
현재 구조는 여행 계획에 한정될 필요가 없습니다.
같은 구조를 다음과 같이 바꿀 수 있습니다.
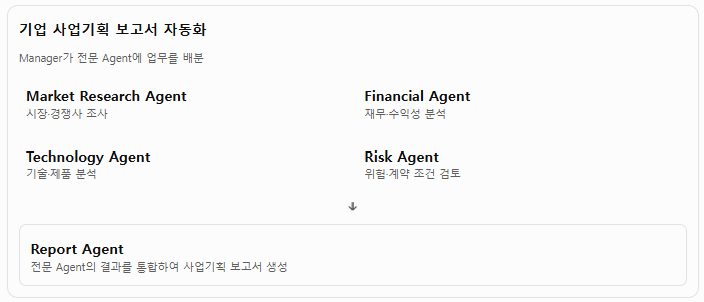
기업 사업기획 보고서 자동화
Manager가 전문 Agent에 업무를 배분
- Market Research Agent
시장·경쟁사 조사
- Financial Agent
재무·수익성 분석
- Technology Agent
기술·제품 분석
- Risk Agent
위험·계약 조건 검토
Report Agent
전문 Agent의 결과를 통합하여 사업기획 보고서 생성
이렇게 구성하면 사업기획, 신사업 검토, 기업 인수 검토, 제품 출시 전략 등으로 확장할 수 있습니다.
핵심은 여행 도메인이 아니라, Manager + 전문 Agent + Document Agent라는 아키텍처에 있습니다.
16. 현재 코드의 기술적 한계와 다음 학습 과제
현재 프로젝트가 잘 작동하더라도 다음 항목은 아직 별도로 구현되지 않았습니다.
| 항목 | 현재 상태 | 향후 방향 |
| Agent 간 통신 | A2A 구현 | 외부 서버 간 통신 및 인증 |
| Agent 발견 | URL 직접 지정 | Agent Registry |
| 업무 결과 | 텍스트 중심 | JSON 구조화 결과 |
| 업무 상태 | 함수 실행 중 대기 | Task 상태 및 진행률 추적 |
| 실패 복구 | 예외 처리 | 재시도·대체 Agent |
| 데이터 저장 | Markdown 로컬 파일 | GCS·DB |
| 대화 기억 | Manager 대화 문맥 | 사용자별 장기 Memory |
| 모니터링 | 콘솔 로그 | OpenTelemetry |
| 결과 검증 | Agent Instruction 중심 | 별도 검증 Agent와 규칙 |
여기서 특히 다음 세 가지는 다음 학습 주제로 추천합니다.
A. 구조화된 결과 전달
현재는 각 Agent가 텍스트를 반환합니다.
제주도 날씨는 맑고...이 방식은 사람이 읽기 쉽지만, 다른 Agent가 데이터를 정확히 처리하기에는 불편합니다.
향후에는 다음과 같은 JSON 구조를 사용하면 좋습니다.
{
  "destination": "제주도",
  "weather": {
    "temperature": "18~22도",
    "precipitation": "확인된 예보 기준",
    "confidence": "예보 기간 내"
  },
  "sources": [
    "공식 기상 정보 URL"
  ]
}
이렇게 하면 Document Agent가 각 필드를 명확하게 구분해 사용할 수 있습니다.
B. Task 상태 관리
현재 Manager는 원격 호출이 끝날 때까지 기다립니다.
하지만 실제 기업용 시스템에서는 다음과 같은 상태가 필요합니다.
SUBMITTED
    ↓
RUNNING
    ↓
COMPLETED
실패하면:
RUNNING
    ↓
FAILED
또는 재시도할 수 있습니다.
사용자에게도 현재 어느 단계인지 알려줄 수 있습니다.
C. 관측성과 로그
현재는 print()로 실행 정보를 출력합니다.
다음 단계에서는 Python Logging과 OpenTelemetry를 도입할 수 있습니다.
예를 들어 한 번의 사용자 요청에 대해 다음과 같은 흐름을 추적하는 것입니다.
Request ID: TRAVEL-001

Manager Agent
  ├─ Weather Agent: 35초
  ├─ Research Agent: 52초
  └─ Document Agent: 18초

Total: 70초 내외
Status: SUCCESS
실제로는 병렬 구간의 완료 시각과 후속 문서 작성 시간을 기준으로 전체 시간을 측정해야 합니다.
이렇게 하면 어떤 Agent가 느린지, 어느 단계에서 실패하는지 확인할 수 있습니다.
17. 전체 프로젝트를 이해했는지 점검하는 핵심 질문
마지막으로 지금까지의 내용을 정리할 수 있도록 여섯 가지 질문을 드리겠습니다.
이해도 확인 문제
1. ADK와 A2A의 역할 차이는 무엇인가?
2. Weather와 Research를 병렬 실행하는 핵심 코드는?
3. Agent Card의 주요 역할은?
4. Document Agent가 파일을 실제로 저장하는 기능은?
5. Weather와 Research가 병렬 실행된 뒤 Document가 실행되는 이유는?
6. 현재 전체 status 판정에서 개선할 점은?
18. 최종 정리: 이 프로젝트에서 얻은 가장 중요한 것
이번 프로젝트에서 배운 것은 단순히 Python으로 AI Agent 네 개를 만든 것이 아닙니다.
다음과 같은 기술을 하나의 시스템으로 연결했다는 데 의미가 있습니다.
-
Google ADK: 전문 Agent를 설계하고 실행하는 방법
-
A2A: 독립된 Agent를 네트워크로 연결하는 방법
-
Agent Card와 Skill: Agent의 역할과 능력을 표준화하는 방법
-
Python 비동기 처리: 여러 Agent를 동시에 실행하는 방법
-
Orchestration: 여러 Agent의 업무를 분배하고 통합하는 방법
-
Python Tool: AI의 결과를 실제 파일로 만드는 방법
-
예외 및 Timeout 처리: 분산 시스템에서 장애를 관리하는 방법
제가 특히 높게 평가하는 부분은 각 Agent의 역할을 분리하고 Manager가 전체 업무를 조율하도록 설계했다는 점입니다.
이것이 바로 단일 챗봇과 멀티 에이전트 시스템의 차이입니다.
다음 단계로는 현재 코드를 무조건 새로 작성하기보다는, 먼저 이 구조를 유지하면서 세 가지를 보완하는 것을 권합니다.
-
원격 Agent 결과를 JSON 형태로 표준화
-
실패·재시도·전체 성공 상태 판정 개선
-
Logging과 OpenTelemetry를 이용한 실행 과정 관측
이 세 가지가 추가되면 현재의 학습용 Travel Planner가 훨씬 견고한 기업형 Multi-Agent 시스템의 기초 모델이 됩니다.
다음에는 이 adk_2를 기준으로 기존 기능을 유지하면서, 코드 중복 제거·설정 통합·구조화된 결과·장애 복구까지 반영한 Multi-Agent Travel Planner 3.0 리팩터링을 진행하면 좋겠습니다.
'Agentic AI > Google ADK' 카테고리의 다른 글
| 30. Agent-to-Agent: Google ADK 기반 A2A. Multi-Agent Travel Planner 1.0 (0) | 2026.11.12 |
|---|---|
| 29. 평가(4.x)- OpenTelemetry 패키지와 Google ADK 사이의 버전 의존성 충돌(Dependency Conflict) (0) | 2026.11.10 |
| 28. 평가(4)- 중앙집중형 관측 체계(Observability) (0) | 2026.11.10 |
| 27. 평가(3)- logging 모듈을 이용한 에이전트 실행과정 기록 (0) | 2026.11.08 |
| 26. 평가(2)- Evalset. ADK Web UI에서 평가 실행 통합테스트 (0) | 2026.11.08 |