32. Deep Research 1.0 시스템 구축
이번에는 단순히 기존 코드를 정리하는 수준이 아니라, 실제 Deep Research 시스템을 구축한다는 관점에서 전체 아키텍처를 재설계하고 최종 실행 코드를 구성하겠습니다. 특히 앞으로 학습하실 A2A, MCP, 멀티 에이전트 오케스트레이션으로도 자연스럽게 확장할 수 있도록 설계하겠습니다.
1. 최신 ADK 기준으로 다시 설계할 방향
여기서 한 가지 중요한 최신화 사항이 있습니다.
2026년 11월 22일 기준 PyPI에서 확인되는 최신 안정 버전은 다음과 같습니다.
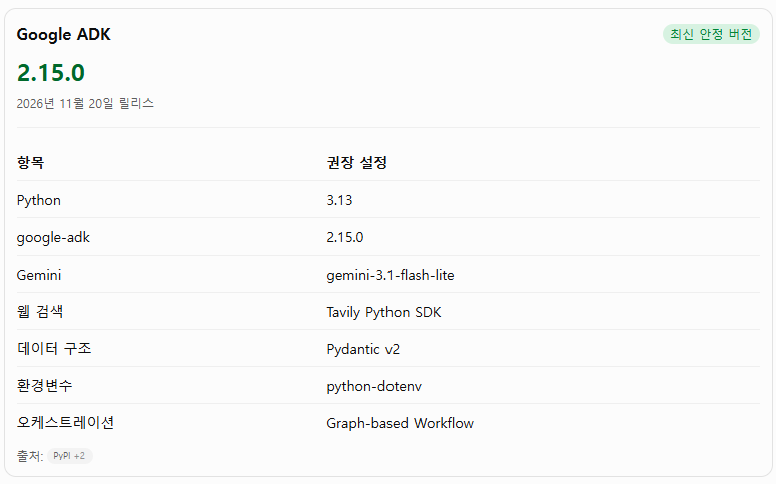
최신 ADK 문서에서는 기존 SequentialAgent, ParallelAgent, LoopAgent 대신 그래프 기반 Workflow를 신규 개발에 권장하고 있습니다. Workflow의 그래프 구조를 채택하겠습니다.
그리고 사용자에게 질문하고 답변을 기다리는 과정은 LLM의 프롬프트에만 맡기지 않고, ADK의 Human-in-the-Loop(HITL) 기능을 활용하겠습니다. ADK 2.x의 RequestInput을 사용하면 워크플로가 사용자 답변을 기다리면서 중단되었다가, 답변을 받으면 다음 단계로 이어질 수 있습니다.
2. 최종 프로젝트 폴더 구조
에이전트별로 폴더와 코드를 분리하는 것이 훨씬 좋습니다.
단, 지나치게 세분화하지 않고 각 에이전트의 역할과 공통 기능을 기준으로 나누겠습니다.
프로젝트 이름은 deep_research로 하겠습니다.
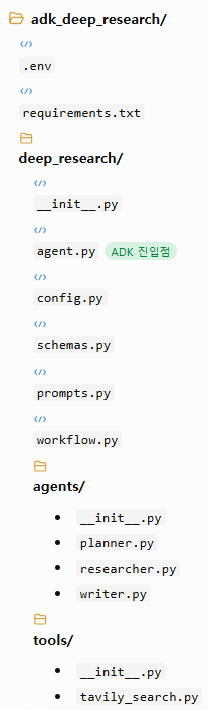
각 파일의 역할은 다음과 같습니다.
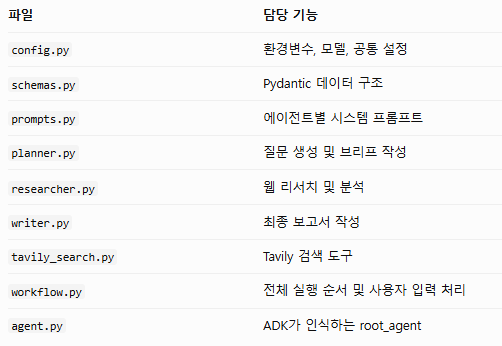
이렇게 구성하면 향후 Researcher를 별도의 A2A 에이전트로 독립시키거나, Tavily 대신 MCP 기반 검색 도구를 연결할 때도 기존 코드를 크게 변경하지 않아도 됩니다.
3. 최종 코드
다음 코드는 위 폴더 구조에 맞춰 작성한 버전입니다.
이번 설계의 실행 흐름은 다음과 같습니다.
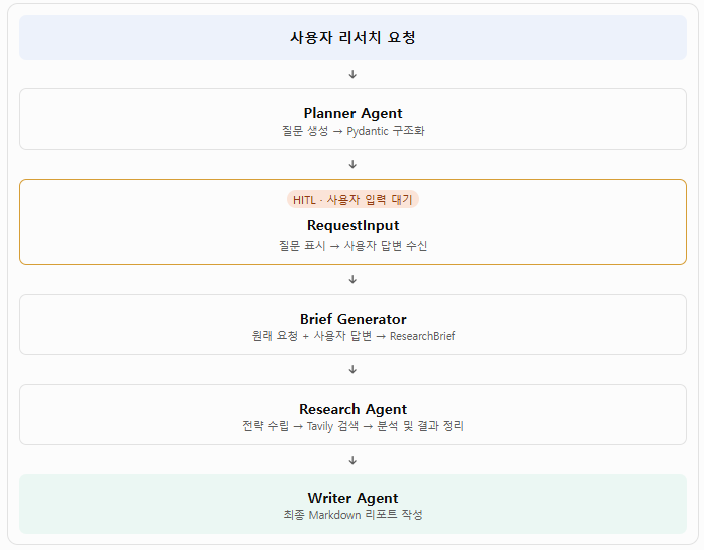
참고로 검색 횟수는 실제 도구에서 제한하도록 개선합니다.
3-1. requirements.txt
google-adk==2.15.0
python-dotenv>=1.0.1
tavily-python>=0.5.0
Pydantic은 Google ADK의 의존성으로 설치되므로 별도 설치하지 않아도 됩니다.
3-2. .env
# Gemini 모델
GOOGLE_MODEL=gemini-3.1-flash-lite

# Tavily API
TAVILY_API_KEY=YOUR_TAVILY_API_KEY

# Google Gemini Developer API 사용 시
GOOGLE_GENAI_USE_VERTEXAI=FALSE
GOOGLE_API_KEY=YOUR_GOOGLE_API_KEY
Vertex AI를 사용하고 싶다면 위 Google API 설정 대신 다음과 같이 설정하면 됩니다.
GOOGLE_GENAI_USE_VERTEXAI=TRUE
GOOGLE_CLOUD_PROJECT=agent-project-512212
GOOGLE_CLOUD_LOCATION=asia-northeast3
Vertex AI 사용 시에는 Google Cloud ADC 인증도 준비해야 합니다.
3-3. deep_research/__init__.py
# Deep Research Agent Package3-4. deep_research/config.py
"""
Deep Research 공통 환경 설정
"""

import os
from pathlib import Path
from datetime import datetime
from zoneinfo import ZoneInfo

from dotenv import load_dotenv


# 프로젝트 루트 경로
PROJECT_ROOT = Path(__file__).resolve().parents[1]

# 프로젝트 루트의 .env 파일 로드
load_dotenv(PROJECT_ROOT / ".env", override=False)


# ============================================================
# 1. Gemini 모델 설정
# ============================================================

MODEL_ID = os.getenv(
    "GOOGLE_MODEL",
    "gemini-3.1-flash-lite"
)


# ============================================================
# 2. Tavily 검색 설정
# ============================================================

TAVILY_API_KEY = os.getenv("TAVILY_API_KEY", "")

MAX_SEARCH_CALLS = 6

SEARCH_MAX_RESULTS = 5


# ============================================================
# 3. 한국 시간 기준 날짜
# ============================================================

KOREA_TZ = ZoneInfo("Asia/Seoul")

TODAY_KST = datetime.now(KOREA_TZ).strftime("%Y-%m-%d")


# ============================================================
# 4. 상태 키
# ============================================================

STATE_ORIGINAL_REQUEST = "original_request"
STATE_CLARIFYING_QUESTIONS = "clarifying_questions"
STATE_USER_RESPONSES = "user_responses"
STATE_RESEARCH_BRIEF = "research_brief"
STATE_RESEARCH_RESULTS = "research_results"
STATE_FINAL_REPORT = "final_report"
3-5. deep_research/schemas.py
"""
Deep Research 에이전트 간 데이터 전달을 위한 Pydantic 스키마
"""

from pydantic import BaseModel, Field


# ============================================================
# 1. 질문 선택지
# ============================================================

class QuestionOption(BaseModel):
    id: str = Field(
        description="선택지 식별자. 예: a, b, c"
    )

    text: str = Field(
        description="사용자에게 보여줄 선택지 내용"
    )


# ============================================================
# 2. 명확화 질문
# ============================================================

class ClarifyingQuestion(BaseModel):

    question: str = Field(
        description="리서치 범위를 구체화하기 위한 질문"
    )

    options: list[QuestionOption] = Field(
        min_length=2,
        max_length=4,
        description="사용자가 선택할 수 있는 2~4개 선택지"
    )

    rationale: str = Field(
        description="이 질문을 하는 이유"
    )


# ============================================================
# 3. 명확화 질문 전체
# ============================================================

class ClarifyingQuestions(BaseModel):

    questions: list[ClarifyingQuestion] = Field(
        min_length=1,
        max_length=3,
        description="최대 3개의 핵심 명확화 질문"
    )


# ============================================================
# 4. 최종 리서치 브리프
# ============================================================

class ResearchBrief(BaseModel):

    title: str = Field(
        description="리서치 프로젝트 제목"
    )

    objective: str = Field(
        description="리서치의 목적"
    )

    scope: str = Field(
        description="리서치의 구체적인 범위"
    )

    key_questions: list[str] = Field(
        min_length=3,
        max_length=5,
        description="리서치에서 답변해야 할 핵심 질문"
    )

    constraints: list[str] = Field(
        default_factory=list,
        description="리서치의 제약 조건"
    )

    expected_output: str = Field(
        description="최종적으로 기대하는 결과물"
    )
3-6. deep_research/prompts.py
모든 에이전트의 시스템 프롬프트를 한 곳에서 관리합니다.
"""
Deep Research 에이전트 시스템 프롬프트
"""

from .config import TODAY_KST


# ============================================================
# 1. Planner - 명확화 질문 생성 프롬프트
# ============================================================

QUESTION_PROMPT = """
당신은 숙련된 리서치 프로젝트 플래너입니다.

사용자의 리서치 요청을 분석하고,
정확한 리서치를 수행하기 위한 명확화 질문을 생성합니다.

[원래 사용자 요청]
{original_request}

[Task]

1. 사용자의 요청에서 핵심 주제와 목적을 파악합니다.
2. 리서치 범위를 구체화하는 질문을 생성합니다.
3. 최대 3개의 질문을 생성합니다.
4. 각 질문에는 2~4개의 구체적인 선택지를 제공합니다.
5. 사용자가 쉽게 선택할 수 있도록 선택지를 명확하게 작성합니다.

[Guidelines]

- 리서치 방향에 가장 큰 영향을 주는 질문부터 생성합니다.
- 조사 대상, 시간 범위, 지역, 비교 기준 등을 고려합니다.
- 이미 명확하게 제시된 내용은 다시 질문하지 않습니다.
- 질문이 불필요한 경우에도 최소 1개의 유의미한
  범위 확인 질문을 생성합니다.

반드시 ClarifyingQuestions 스키마에 맞춰 반환하세요.
"""


# ============================================================
# 2. Planner - Research Brief 생성 프롬프트
# ============================================================

BRIEF_PROMPT = """
당신은 전문 리서치 프로젝트 기획자입니다.

사용자의 최초 요청과 명확화 질문에 대한 답변을
종합하여 최종 Research Brief를 작성합니다.

[최초 사용자 요청]
{original_request}

[명확화 질문]
{clarifying_questions}

[사용자 답변]
{user_responses}

[Task]

위의 세 가지 정보를 종합하여 다음 항목을 작성하세요.

1. title: 리서치 프로젝트 제목
2. objective: 리서치 목적
3. scope: 조사 대상과 범위
4. key_questions: 핵심 리서치 질문 3~5개
5. constraints: 조사 시 고려해야 할 제약 조건
6. expected_output: 최종 결과물의 형태

[Guidelines]

- 최초 사용자 요청을 가장 중요한 기준으로 삼습니다.
- 사용자 답변을 반영하여 조사 범위를 구체화합니다.
- 모호한 내용을 임의로 사실처럼 확정하지 않습니다.
- 실제 리서치 에이전트가 바로 실행할 수 있을 정도로
  구체적인 브리프를 작성합니다.

반드시 ResearchBrief 스키마에 맞춰 반환하세요.
"""


# ============================================================
# 3. Researcher - 웹 리서치 프롬프트
# ============================================================

RESEARCH_PROMPT = f"""
당신은 숙련된 Deep Research 에이전트입니다.

오늘 날짜: {TODAY_KST}

[리서치 브리프]
{{research_brief}}

[목표]

Research Brief에 명시된 핵심 질문에 답변하기 위해
신뢰할 수 있는 최신 정보를 수집하고 분석합니다.

[Workflow]

1. 리서치 브리프를 분석합니다.
2. 핵심 질문별로 검색 전략을 수립합니다.
3. web_search 도구를 이용하여 자료를 검색합니다.
4. 검색 결과의 신뢰성과 관련성을 검토합니다.
5. 여러 출처의 내용을 비교하고 교차 검증합니다.
6. 핵심 발견사항과 분석 결과를 정리합니다.
7. 근거가 충분하지 않은 내용은 불확실성을 표시합니다.

[검색 원칙]

- 최대 6회의 웹 검색을 활용합니다.
- 핵심 질문별로 구체적인 검색어를 사용합니다.
- 최신 정보가 중요한 주제는 최신 자료를 우선합니다.
- 공식 기관, 기업, 연구기관 및 전문 매체를 우선합니다.
- 하나의 출처만으로 중요한 결론을 내리지 않습니다.
- 검색 결과에 없는 내용을 사실처럼 만들어내지 않습니다.

[결과 작성 형식]

1. Research Overview
2. Key Findings
3. Detailed Analysis
4. Comparative Analysis (필요한 경우)
5. Risks and Limitations
6. Source Materials

각 주요 발견사항에는 근거가 되는 출처 URL을 명시하세요.

검색 자료와 분석 결과를 구분하고,
최종 보고서 작성자가 활용할 수 있도록
충분히 구체적인 리서치 결과를 반환하세요.
"""


# ============================================================
# 4. Writer - 최종 리포트 작성 프롬프트
# ============================================================

WRITE_PROMPT = """
당신은 전문 리서치 보고서 작성자입니다.

사용자에게 직접 제공할 최종 보고서를 작성합니다.

[Research Brief]
{research_brief}

[Research Results]
{research_results}

[Task]

리서치 브리프와 검색 및 분석 결과를 바탕으로
전문적이고 완성도 높은 최종 보고서를 작성하세요.

[출력 형식]

# 리서치 보고서 제목

## 1. 핵심 요약
- 가장 중요한 발견사항을 3~5개로 정리합니다.

## 2. 리서치 개요
- 조사 목적
- 조사 범위
- 핵심 질문

## 3. 주요 발견사항
- 핵심 사실과 발견사항
- 주요 수치와 통계
- 중요한 변화 및 동향

## 4. 상세 분석
- 항목별 심층 분석
- 비교 분석
- 주요 시사점

## 5. 위험 요소 및 고려사항
- 불확실성
- 한계
- 추가 검증이 필요한 내용

## 6. 종합 결론 및 제언
- 핵심 결론
- 실무적인 시사점
- 향후 대응 방향

## 7. 참고 출처
- 출처명
- URL
- 활용한 정보의 내용

[작성 원칙]

1. 반드시 Markdown으로 작성합니다.
2. JSON 형식으로 출력하지 않습니다.
3. 검색 결과에 없는 사실이나 출처를 만들어내지 않습니다.
4. 주요 주장에는 가능한 한 출처를 연결합니다.
5. 사실, 분석, 의견을 구분합니다.
6. 중복되는 내용을 최소화합니다.
7. 한국어로 전문적이고 읽기 쉽게 작성합니다.

최종 보고서만 출력하세요.
"""
3-7. deep_research/tools/__init__.py
# Deep Research Tools Package3-8. deep_research/tools/tavily_search.py
검색 횟수를 실제로 제한하도록 했습니다.
프롬프트에만 최대 호출 횟수를 지정하는 것이 아니라 ToolContext의 상태를 활용합니다.
"""
Tavily 웹 검색 도구
"""

import json
import os

from tavily import TavilyClient
from google.adk.tools import ToolContext

from ..config import MAX_SEARCH_CALLS, SEARCH_MAX_RESULTS


def web_search(
    query: str,
    tool_context: ToolContext,
) -> str:
    """
    Tavily를 이용하여 웹 검색을 수행합니다.

    Args:
        query: 검색할 키워드 또는 질문
        tool_context: ADK ToolContext

    Returns:
        검색 결과를 JSON 문자열로 반환
    """

    # --------------------------------------------------------
    # 1. 검색 횟수 확인
    # --------------------------------------------------------

    search_count = tool_context.state.get(
        "temp:search_call_count", 0
    )

    if search_count >= MAX_SEARCH_CALLS:
        return json.dumps(
            {
                "error": "검색 호출 한도에 도달했습니다.",
                "max_search_calls": MAX_SEARCH_CALLS,
            },
            ensure_ascii=False,
        )

    # 실제 검색을 시도하기 전에 횟수 증가
    tool_context.state["temp:search_call_count"] = (
        search_count + 1
    )

    # --------------------------------------------------------
    # 2. 검색어 검증
    # --------------------------------------------------------

    query = query.strip()

    if not query:
        return json.dumps(
            {"error": "검색어가 비어 있습니다."},
            ensure_ascii=False,
        )

    # --------------------------------------------------------
    # 3. API Key 확인
    # --------------------------------------------------------

    api_key = os.getenv("TAVILY_API_KEY")

    if not api_key:
        return json.dumps(
            {"error": "TAVILY_API_KEY가 설정되지 않았습니다."},
            ensure_ascii=False,
        )

    # --------------------------------------------------------
    # 4. Tavily 검색
    # --------------------------------------------------------

    try:

        tavily_client = TavilyClient(
            api_key=api_key
        )

        response = tavily_client.search(
            query=query,
            search_depth="advanced",
            max_results=SEARCH_MAX_RESULTS,
        )

        # ----------------------------------------------------
        # 5. 검색 결과 정리
        # ----------------------------------------------------

        results = []

        for item in response.get("results", []):

            results.append(
                {
                    "title": item.get("title", ""),
                    "url": item.get("url", ""),
                    "content": item.get("content", "")[:2000],
                    "score": item.get("score"),
                    "published_date": item.get(
                        "published_date"
                    ),
                }
            )

        result_data = {
            "query": query,
            "search_count": search_count + 1,
            "total_results": len(results),
            "results": results,
        }

        return json.dumps(
            result_data,
            ensure_ascii=False,
            indent=2,
        )

    except Exception as e:

        return json.dumps(
            {
                "error": "Tavily 검색 중 오류가 발생했습니다.",
                "detail": str(e),
            },
            ensure_ascii=False,
        )
참고: temp: 상태는 현재 invocation 동안 사용하는 임시 상태입니다. 여러 검색 도구 호출이 동시에 실행되는 경우에는 호출 횟수 제한을 별도의 동기화 방식으로 강화해야 합니다.
3-9. deep_research/agents/__init__.py
# Deep Research Agents Package3-10. deep_research/agents/planner.py
Planner는 두 개의 에이전트로 구성합니다.
-
questions_agent: 명확화 질문 생성
-
brief_agent: 사용자 답변을 반영한 Research Brief 작성
두 에이전트를 하나의 일반 Agent에 sub_agents로 넣는 방식이 아닌, Workflow가 두 에이전트의 실행 순서를 관리합니다.
"""
Planner Agent

1. Questions Generator
2. Brief Generator
"""

from google.adk import Agent

from ..config import MODEL_ID
from ..schemas import (
    ClarifyingQuestions,
    ResearchBrief,
)
from ..prompts import (
    QUESTION_PROMPT,
    BRIEF_PROMPT,
)


# ============================================================
# 1. 명확화 질문 생성 에이전트
# ============================================================

questions_agent = Agent(

    name="questions_generator",

    model=MODEL_ID,

    mode="single_turn",

    description="사용자 요청을 분석하고 명확화 질문을 생성합니다.",

    instruction=QUESTION_PROMPT,

    output_schema=ClarifyingQuestions,

    output_key="clarifying_questions",
)


# ============================================================
# 2. Research Brief 생성 에이전트
# ============================================================

brief_agent = Agent(

    name="brief_generator",

    model=MODEL_ID,

    mode="single_turn",

    description="사용자 요청과 답변을 바탕으로 Research Brief를 작성합니다.",

    instruction=BRIEF_PROMPT,

    output_schema=ResearchBrief,

    output_key="research_brief",
)
3-11. deep_research/agents/researcher.py
"""
Research Agent
"""

from google.adk import Agent

from ..config import MODEL_ID
from ..prompts import RESEARCH_PROMPT
from ..tools.tavily_search import web_search


# ============================================================
# Research Agent
# ============================================================

research_agent = Agent(

    name="research_agent",

    model=MODEL_ID,

    mode="single_turn",

    description="Research Brief를 바탕으로 웹 검색과 심층 분석을 수행합니다.",

    instruction=RESEARCH_PROMPT,

    tools=[
        web_search,
    ],

    output_key="research_results",
)
3-12. deep_research/agents/writer.py
"""
Writer Agent
"""

from google.adk import Agent

from ..config import MODEL_ID
from ..prompts import WRITE_PROMPT


# ============================================================
# Writer Agent
# ============================================================

writer_agent = Agent(

    name="writer_agent",

    model=MODEL_ID,

    mode="single_turn",

    description="리서치 결과를 바탕으로 최종 Markdown 보고서를 작성합니다.",

    instruction=WRITE_PROMPT,

    output_key="final_report",
)
3-13. deep_research/workflow.py
이 파일이 이번 프로젝트에서 가장 중요한 부분입니다.
전체 실행 순서와 사용자 답변을 기다리는 과정을 관리합니다.
여기서 최신 ADK의 Workflow, Event, RequestInput을 사용합니다.
"""
Deep Research Graph Workflow

실행 순서:

1. 사용자 요청 저장
2. 명확화 질문 생성
3. 사용자 답변 대기 (HITL)
4. 사용자 답변 저장
5. Research Brief 생성
6. 웹 리서치
7. 최종 보고서 작성
"""

from google.adk import Event, Workflow
from google.adk.events import RequestInput

from .schemas import ClarifyingQuestions

from .agents.planner import (
    questions_agent,
    brief_agent,
)

from .agents.researcher import research_agent

from .agents.writer import writer_agent


# ============================================================
# 1. 최초 사용자 요청 저장
# ============================================================

def capture_request(node_input: str) -> Event:
    """
    최초 사용자 요청을 session.state에 저장합니다.

    다음 노드에도 원래 요청을 전달합니다.
    """

    original_request = str(node_input).strip()

    return Event(
        output=original_request,
        state={
            "original_request": original_request
        },
    )


# ============================================================
# 2. 사용자 답변 요청 (Human-in-the-Loop)
# ============================================================

async def request_user_answers(
    questions: ClarifyingQuestions,
):
    """
    질문 생성 결과를 사용자에게 전달하고
    답변이 입력될 때까지 Workflow를 일시 중단합니다.
    """

    question_lines = []

    for index, question in enumerate(
        questions.questions,
        start=1,
    ):

        question_lines.append(
            f"Q{index}. {question.question}"
        )

        if question.rationale:
            question_lines.append(
                f"질문 이유: {question.rationale}"
            )

        for option in question.options:

            question_lines.append(
                f"- {option.id}: {option.text}"
            )

        question_lines.append("")

    message = (
        "### 정확한 리서치를 위해 몇 가지 확인이 필요합니다.\n\n"
        + "\n".join(question_lines)
        + "\n답변 예시: `1-a, 2-b`"
    )

    yield RequestInput(
        message=message,
        payload=questions.model_dump(),
    )


# ============================================================
# 3. 사용자 답변 저장
# ============================================================

def save_user_response(node_input) -> Event:
    """
    사용자가 입력한 답변을 session.state에 저장합니다.
    """

    if isinstance(node_input, dict):

        user_responses = str(node_input)

    else:

        user_responses = str(node_input).strip()

    return Event(
        output=user_responses,
        state={
            "user_responses": user_responses
        },
    )


# ============================================================
# 4. 전체 Graph Workflow
# ============================================================

root_agent = Workflow(

    name="deep_research_pipeline",

    edges=[
        (
            "START",

            # 1. 최초 요청 저장
            capture_request,

            # 2. 명확화 질문 생성
            questions_agent,

            # 3. 사용자 답변 요청 및 대기
            request_user_answers,

            # 4. 사용자 답변 저장
            save_user_response,

            # 5. Research Brief 생성
            brief_agent,

            # 6. 웹 리서치 및 분석
            research_agent,

            # 7. 최종 보고서 작성
            writer_agent,
        )
    ],
)
여기서 중요한 점은 RequestInput입니다.
일반적인 함수처럼 사용자에게 질문 메시지를 출력하고 바로 다음 단계로 넘어가는 것이 아닙니다.
실제 사용자가 답변할 때까지 워크플로가 중단되고, 답변이 들어오면 save_user_response부터 후속 단계가 이어지는 구조입니다.
이것은 ADK의 그래프 워크플로에서 공식적으로 지원하는 Human-in-the-Loop 방식입니다.
3-14. deep_research/agent.py
ADK가 프로젝트를 인식하는 진입점입니다.
"""
Deep Research Agent Entry Point
"""

from .workflow import root_agent
이렇게 하면 adk web이 root_agent를 찾아 실행할 수 있습니다.
4. 추가 보완 사항
한 가지 보완할 사항이 있습니다. request_user_answers()에서 Pydantic 객체가 전달된다는 가정을 조금 더 안전하게 처리하는 편이 좋습니다. ADK 버전이나 노드의 출력 처리에 따라 dict 형태로 전달되는 경우도 고려해야 합니다.
따라서 workflow.py의 질문 입력 부분은 아래처럼 변경하는 것을 권장합니다.
import json
from typing import Any

def _coerce_questions(value: Any) -> ClarifyingQuestions:
    """질문 데이터를 Pydantic 객체로 변환합니다."""

    if isinstance(value, ClarifyingQuestions):
        return value

    if isinstance(value, dict):
        return ClarifyingQuestions.model_validate(value)

    if isinstance(value, str):
        return ClarifyingQuestions.model_validate_json(value)

    raise TypeError(
        f"지원하지 않는 질문 데이터 형식: {type(value)}"
    )


async def request_user_answers(node_input: Any):
    """질문을 표시하고 사용자 답변을 기다립니다."""

    questions = _coerce_questions(node_input)

    question_lines = []

    for index, question in enumerate(
        questions.questions, start=1
    ):
        question_lines.append(
            f"Q{index}. {question.question}"
        )

        for option in question.options:
            question_lines.append(
                f"- {option.id}: {option.text}"
            )

        question_lines.append("")

    message = (
        "### 정확한 리서치를 위해 확인이 필요합니다.\n\n"
        + "\n".join(question_lines)
        + "\n답변 예시: `1-a, 2-b`"
    )

    yield RequestInput(
        message=message,
        payload=questions.model_dump(),
    )
이 코드를 기존 workflow.py의 request_user_answers() 대신 사용하면 됩니다. 나머지 함수와 Workflow 구성은 그대로 유지합니다.
또한 검색 횟수 제한은 일반적인 순차 호출에서는 작동하지만, 병렬 도구 호출이 발생하면 동시성 제어를 추가해야 완전한 강제 제한이 됩니다.
5. 실행 방법
Windows PowerShell 환경을 기준으로 설명하겠습니다.
① 프로젝트 폴더 이동
cd C:\Dev\book_agentic_ai\adk_deep_research
② 가상환경 활성화
기존 가상환경을 사용한다면 해당 환경을 활성화합니다.
.\venv\Scripts\Activate.ps1
③ ADK 및 라이브러리 설치
python -m pip install -r requirements.txt
버전 확인:
python -m pip show google-adk④ 프로젝트 폴더 구조 확인
tree /F
⑤ ADK Web 실행
adk web --port 8080브라우저에서 다음 주소로 접속합니다.
프로젝트 목록에서 deep_research를 선택하여 테스트합니다.
6. 실행 환경에 대한 추가 권장사항
이전에 사용하시던 ADK 학습 환경은 2.13.0을 기준으로 작업하셨던 것으로 기억합니다.
이번 프로젝트는 2.15.0을 기준으로 별도의 가상환경을 만드는 것을 권장합니다. 특히 기존 OpenTelemetry 패키지 충돌을 경험하셨으므로 기존 환경을 직접 업그레이드하는 것보다 독립적인 환경이 안전합니다.
cd C:\Dev\book_agentic_ai

python -m venv adk_deep_research\venv

cd adk_deep_research

.\venv\Scripts\Activate.ps1

python -m pip install -r requirements.txt
7. 최종적으로 제가 제안하는 개발 방향
이번 코드는 Deep Research의 기본형이라고 생각하시면 됩니다.
향후 다음과 같이 확장하면 좋겠습니다.
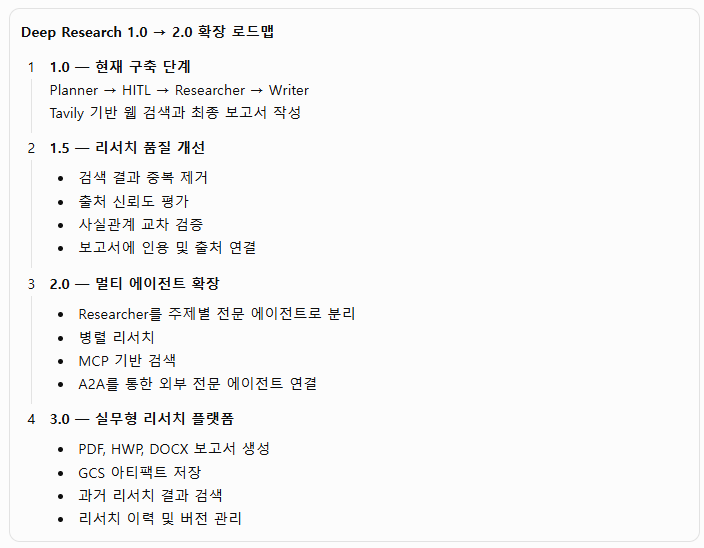
특히 향후에는 다음과 같은 구조가 상당히 유용할 것입니다.

예를 들어 하나의 리서치 요청을 받으면 다음과 같이 전문 에이전트들이 병렬로 조사하는 방식입니다.
-
시장조사 에이전트
-
기술조사 에이전트
-
경쟁사 분석 에이전트
-
정책 및 규제 조사 에이전트
-
종합 분석 및 보고서 작성 에이전트
이런 구조는 지금까지 공부하셨던 ADK, A2A, MCP를 실제 하나의 응용 시스템으로 통합하는 좋은 프로젝트가 될 수 있습니다.
마지막으로 중요한 점: 위 코드는 최신 ADK 공식 API와 문서에 맞춰 작성한 설계 및 코드 초안입니다. 실제 Windows 환경에서 실행 검증을 완료한 코드는 아니므로, 특히 RequestInput의 중단·재개, 그래프 노드 간 Pydantic 데이터 전달, adk web의 상태 표시를 첫 실행에서 확인해야 합니다.
참고할 공식 문서:
다음 단계에서는 이번 최종 코드를 기준으로 config.py부터 schemas.py, 각 에이전트, Tavily 도구, Workflow까지 실제 코드 한 줄 한 줄의 의미, ADK 내부 동작 원리, 데이터가 에이전트 사이에서 전달되는 과정, 실행 시 발생하는 이벤트와 session.state의 변화를 차례대로 상세하게 공부하면 좋겠습니다.