33. Deep Research 1.0 시스템 코드 해설(1/3)
단순히 Python 문법을 설명하는 데 그치지 않고, 왜 이런 코드를 작성했는지, 실제 실행될 때 어떤 일이 일어나는지, Google ADK의 Agent와 Tool이 이 코드를 어떻게 활용하는지까지 연결해서 설명합니다.
특히 이번 세 파일은 Deep Research 시스템의 기초를 이루는 중요한 코드입니다.
-
config.py: 시스템 전체의 환경과 설정을 관리하는 곳
-
schemas.py: 에이전트 사이에서 주고받는 데이터의 형식을 정의하는 곳
-
tavily_search.py: Research Agent가 실제 인터넷 검색을 수행하도록 연결하는 도구
먼저 전체적인 관계를 이해하고, 그다음 파일별로 한 줄씩 살펴보겠습니다.
1. 세 파일의 관계부터 이해하기
우리가 구축한 Deep Research 시스템을 하나의 연구조직이라고 생각해 보겠습니다.
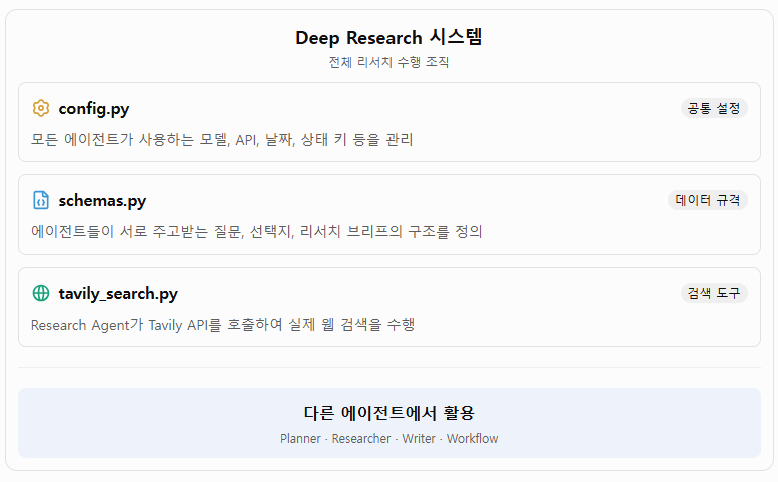
이 세 파일은 각각 독립적으로 실행하는 프로그램이라기보다는 다른 에이전트들이 가져다 사용하는 공통 구성요소입니다.
예를 들어 researcher.py에서는 다음과 같이 사용합니다.
from ..config import MODEL_ID
from ..prompts import RESEARCH_PROMPT
from ..tools.tavily_search import web_search
여기서 각각 다음 역할을 합니다.
-
MODEL_ID: 어떤 Gemini 모델을 사용할 것인가?
-
RESEARCH_PROMPT: Research Agent에게 어떤 일을 시킬 것인가?
-
web_search: 인터넷 검색을 어떻게 수행할 것인가?
즉, 설정과 데이터 규격, 실제 기능을 분리해 놓은 것입니다.
2. deep_research/config.py 상세 해설
2-1. 이 파일의 목적
config.py는 프로젝트 전체의 공통 설정을 한 곳에서 관리하는 파일입니다.
왜 이런 파일이 필요할까요?
가령 우리가 Gemini 모델을 변경한다고 가정하겠습니다.
현재 프로젝트의 여러 파일에서 다음과 같이 모델을 직접 지정한다면 어떻게 될까요?
# planner.py
model="gemini-3.1-flash-lite"

# researcher.py
model="gemini-3.1-flash-lite"

# writer.py
model="gemini-3.1-flash-lite"
나중에 모델을 변경할 때 세 파일을 모두 수정해야 합니다.
반면 config.py에서 한 번만 변경하고 다른 파일에서는 가져다 쓰면 됩니다.
MODEL_ID = "gemini-3.1-flash-lite"그리고 다른 파일에서는 다음과 같이 사용합니다.
from ..config import MODEL_ID이것이 바로 중앙집중형 설정 관리(Centralized Configuration)입니다.
2-2. 코드 한 줄씩 해설
① 모듈 설명
"""Deep Research 공통 환경 설정"""Python에서는 세 개의 큰따옴표로 감싼 문자열을 사용할 수 있습니다.
이를 Docstring이라고 합니다.
일반적인 주석(#)과 달리 모듈, 클래스, 함수 등의 설명을 기록하는 공식적인 문서 문자열입니다.
예를 들어 다음과 같이 확인할 수 있습니다.
import deep_research.config
print(deep_research.config.__doc__)
출력:
Deep Research 공통 환경 설정즉, 이 파일이 어떤 목적으로 만들어졌는지를 설명하는 것입니다.
② 라이브러리 가져오기
import os
from pathlib import Path
from datetime import datetime
from zoneinfo import ZoneInfo

from dotenv import load_dotenv
각각의 라이브러리가 담당하는 역할을 살펴보겠습니다.
| 라이브러리 | 역할 | 이번 프로젝트에서의 용도 |
| os | 운영체제 환경과 파일 관련 기능 | 환경변수 읽기 |
| Path | 파일 및 폴더 경로 관리 | 프로젝트 경로 계산 |
| datetime | 날짜와 시간 처리 | 현재 날짜 확인 |
| ZoneInfo | 시간대 처리 | 한국 시간대 적용 |
| load_dotenv | .env 파일 읽기 | API 키 및 모델 설정 로드 |
여기서 특히 os와 dotenv의 관계를 이해하는 것이 중요합니다.
.env 파일에 다음과 같이 작성했다고 가정하겠습니다.
GOOGLE_MODEL=gemini-3.1-flash-lite
TAVILY_API_KEY=tvly-xxxxxxxx
이 파일은 일반적인 텍스트 파일입니다. Python이 자동으로 이 파일을 읽는 것은 아닙니다. 따라서 load_dotenv()를 이용하여 .env에 작성된 내용을 Python의 환경변수 영역에 등록하는 것입니다. 그 후 os.getenv()를 통해 읽을 수 있습니다.
즉 다음과 같은 관계입니다.
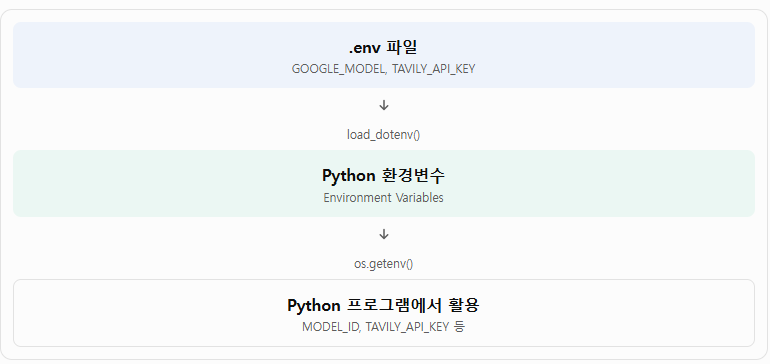
이렇게 이해하시면 됩니다.
③ 프로젝트 루트 경로 계산
PROJECT_ROOT = Path(__file__).resolve().parents[1]이 부분은 처음에는 다소 낯설 수 있지만, Python 프로젝트를 관리할 때 상당히 유용한 코드입니다.
먼저 각각의 요소를 살펴보겠습니다.
__file__
현재 실행되고 있는 Python 파일의 경로를 의미합니다.
우리가 작성한 파일이 다음 위치에 있다고 가정하겠습니다.
C:\Dev\book_agentic_ai\adk_deep_research\
    deep_research\
        config.py
이때 __file__은 다음과 같은 경로를 가리킵니다.
C:\Dev\book_agentic_ai\adk_deep_research\deep_research\config.pyPath(__file__)
문자열 형태의 파일 경로를 Python의 Path 객체로 변환합니다.
Path 객체를 사용하면 폴더 이동이나 경로 결합 등을 편리하게 처리할 수 있습니다.
.resolve()
상대 경로를 절대 경로로 바꾸고 경로를 정규화합니다.
.parents[1]
현재 파일이 속한 폴더의 상위 폴더를 순서대로 접근합니다.
다음 그림을 보시면 이해하기 쉽습니다.
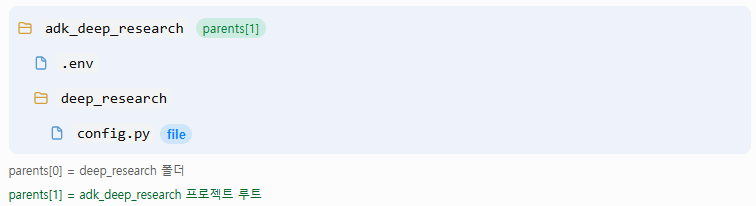
따라서 최종적으로 다음 경로를 얻게 됩니다.
C:\Dev\book_agentic_ai\adk_deep_research이렇게 해두면 프로그램을 어느 작업 디렉터리에서 실행하든 프로젝트 루트 경로를 안정적으로 찾을 수 있습니다.
④ .env 파일 로드
load_dotenv(PROJECT_ROOT / ".env", override=False)이 코드는 앞에서 구한 프로젝트 루트에 있는 .env 파일을 읽어 환경변수로 등록합니다.
여기서 다음 두 가지가 중요합니다.
첫째, PROJECT_ROOT / ".env"
Python의 Path 객체는 / 연산자를 이용하여 경로를 결합할 수 있습니다.
예를 들어:
PROJECT_ROOT = Path("C:/Dev/adk_deep_research")

env_path = PROJECT_ROOT / ".env"

print(env_path)
결과:
C:\Dev\adk_deep_research\.env일반 문자열을 연결하는 것과 달리 운영체제에 맞는 경로를 만들어 줍니다.
둘째, override=False
이것은 매우 중요합니다.
.env에 저장된 환경변수와 이미 운영체제에 등록되어 있는 환경변수가 서로 다를 경우 어떤 값을 사용할지 결정합니다.
| 설정 | 동작 |
| override=False | 이미 존재하는 운영체제 환경변수를 우선 |
| override=True | .env 파일의 값을 우선 |
예를 들어 Windows 환경변수에 다음과 같이 등록되어 있다고 가정하겠습니다.
GOOGLE_MODEL=gemini-3.1-pro그런데 .env 파일에는 다음과 같이 적혀 있습니다.
GOOGLE_MODEL=gemini-3.1-flash-liteoverride=False이면 기존 Windows 환경변수의 값인 gemini-3.1-pro를 사용합니다.
반대로 override=True이면 .env의 값인 gemini-3.1-flash-lite를 사용합니다.
제 의견: 현재 설정인 override=False가 일반적인 운영환경에서는 더 안전합니다. 특히 서버 환경이나 Docker 환경에서 외부 환경변수를 명시적으로 지정할 수 있기 때문입니다.
⑤ Gemini 모델 설정
MODEL_ID = os.getenv(
    "GOOGLE_MODEL",
    "gemini-3.1-flash-lite"
)os.getenv()는 운영체제에 등록된 환경변수를 가져오는 함수입니다.
첫 번째 인수는 가져올 환경변수 이름입니다.
두 번째 인수는 해당 환경변수가 없을 때 사용할 기본값입니다.
즉 다음과 같은 의미입니다.
-
.env에 GOOGLE_MODEL이 있으면 그 값을 사용합니다.
-
없으면 gemini-3.1-flash-lite를 사용합니다.
예를 들어:
GOOGLE_MODEL=gemini-3.1-flash-lite이렇게 설정되어 있으면:
print(MODEL_ID)결과는 다음과 같습니다.
gemini-3.1-flash-lite이후 Planner, Researcher, Writer가 이 변수를 공유합니다.
참고로 MODEL_ID는 Python 변수 이름일 뿐이며, 실제 모델을 선택하고 실행하는 것은 ADK와 Gemini 연동 계층입니다.
⑥ Tavily 검색 설정
TAVILY_API_KEY = os.getenv("TAVILY_API_KEY", "")
MAX_SEARCH_CALLS = 6
SEARCH_MAX_RESULTS = 5
세 변수의 의미를 구분해서 이해하시면 좋겠습니다.
| 변수 | 의미 | 설정 |
| TAVILY_API_KEY | Tavily 인증 키 | .env에서 읽음 |
| MAX_SEARCH_CALLS | Research Agent의 검색 도구 호출 허용 횟수 | 6회 |
| SEARCH_MAX_RESULTS | 검색 한 번에 가져올 결과 수 | 5개 |
여기서 중요한 차이가 있습니다.
MAX_SEARCH_CALLS = 6은 전체 검색 결과가 6개라는 의미가 아닙니다.
검색 도구를 최대 6번 호출할 수 있다는 의미입니다.
그리고 SEARCH_MAX_RESULTS = 5는 검색을 한 번 수행할 때 최대 5개의 결과를 가져오도록 Tavily에 요청한다는 뜻입니다.
따라서 이론상 최대 검색 결과 수는 다음과 같습니다.
즉, 최대 6번 검색하고 검색당 5개씩 가져오면 최대 30개의 검색 결과를 수집할 수 있습니다.
단, 실제 검색 결과 수는 Tavily가 반환하는 결과에 따라 달라집니다.
⑦ 한국 시간대 설정
KOREA_TZ = ZoneInfo("Asia/Seoul")
TODAY_KST = datetime.now(KOREA_TZ).strftime("%Y-%m-%d")
이 코드는 리서치 에이전트가 현재 날짜를 정확히 인식하도록 만드는 설정입니다.
먼저:
KOREA_TZ = ZoneInfo("Asia/Seoul")ZoneInfo는 Python 표준 라이브러리의 시간대 처리 기능입니다.
한국의 시간대는 Asia/Seoul이며 UTC보다 9시간 빠릅니다.
즉: KST = UTC + 9
다음으로:
datetime.now(KOREA_TZ)한국 시간대를 기준으로 현재 날짜와 시간을 가져옵니다.
예를 들어 다음과 같은 값이 반환될 수 있습니다.
2026-11-22 19:02:00+09:00여기서:
.strftime("%Y-%m-%d")날짜와 시간을 원하는 문자열 형식으로 바꿉니다.
| 형식 | 의미 | 결과 예시 |
| %Y | 4자리 연도 | 2026 |
| %m | 2자리 월 | 11 |
| %d | 2자리 일 | 22 |
최종 결과:
2026-11-22이 값을 Researcher의 시스템 프롬프트에 넣습니다.
RESEARCH_PROMPT = f"""
오늘 날짜: {TODAY_KST}
...
"""
왜 날짜가 필요할까요?
예를 들어 사용자가 다음과 같이 요청했다고 가정하겠습니다.
"2026년 한국 AI 시장의 최신 동향을 조사해줘."
Research Agent는 현재 날짜를 기준으로 최신 자료를 판단할 수 있습니다.
다만 이 날짜는 프롬프트가 만들어지는 시점에 한 번 계산됩니다. 장시간 실행되는 프로세스에서 자정이 지나도 자동으로 갱신되지는 않는다는 점은 알아두세요.
⑧ 상태 키 정의
STATE_ORIGINAL_REQUEST = "original_request"
STATE_CLARIFYING_QUESTIONS = "clarifying_questions"
STATE_USER_RESPONSES = "user_responses"
STATE_RESEARCH_BRIEF = "research_brief"
STATE_RESEARCH_RESULTS = "research_results"
STATE_FINAL_REPORT = "final_report"
여기가 ADK 학습에서 특히 중요한 부분입니다.
우리가 구축한 시스템은 여러 에이전트가 순차적으로 실행됩니다.
그 과정에서 앞 단계의 결과를 다음 단계에서 사용할 수 있어야 합니다.
이를 위해 ADK의 session.state를 활용합니다.
예를 들어:
tool_context.state["original_request"] = "한국 AI 시장 조사"이렇게 저장하면 세션 상태에 다음과 같은 데이터가 기록되는 구조입니다.
{ "original_request": "한국 AI 시장 조사"}다음 에이전트에서 이를 읽을 수 있습니다.
original_request = session.state.get("original_request")여기서 STATE_ORIGINAL_REQUEST는 문자열을 직접 반복해서 쓰지 않기 위해 정의한 상수입니다.
실제로는 다음과 같이 사용합니다.
from ..config import STATE_ORIGINAL_REQUEST
value = session.state.get(STATE_ORIGINAL_REQUEST)
이렇게 하면 나중에 상태 키를 변경하더라도 config.py만 수정하면 됩니다.
한 가지 구분할 점은 STATE_ 변수들이 ADK가 특별하게 인식하는 예약어는 아니라는 것입니다. 우리가 프로젝트의 일관성을 위해 만든 일반 Python 상수입니다.
2-3. config.py 전체 동작 정리
config.py 실행 과정
-
Python이 config.py를 import합니다.
-
프로젝트 루트 경로를 계산합니다.
-
프로젝트 루트의 .env 파일을 읽습니다.
-
Gemini 모델과 Tavily API 설정을 가져옵니다.
-
한국 시간 기준 오늘 날짜를 계산합니다.
-
에이전트 간 데이터 공유에 사용할 상태 키를 정의합니다.
핵심 이해: config.py는 일반적으로 프로그램 시작 시 다른 모듈이 처음 import할 때 실행되고, 그 결과 만들어진 설정값을 다른 모듈이 재사용하는 구조입니다.
3. deep_research/schemas.py 상세 해설
이제 두 번째 파일입니다.
개인적으로는 멀티 에이전트 시스템을 이해할 때 schemas.py가 상당히 중요한 파일이라고 생각합니다.
왜냐하면 에이전트가 여러 개 존재한다는 것은 서로 데이터를 주고받는다는 뜻이기 때문입니다.
그런데 에이전트마다 데이터의 형식이 다르면 문제가 발생합니다.
예를 들어 Planner가 질문을 다음과 같이 반환했다고 생각해 보겠습니다.
{ "question": "어느 시장을 조사할까요?"}그런데 다음 단계의 프로그램은 다음과 같은 구조를 기대한다면 어떨까요?
{
    "question_text": "어느 시장을 조사할까요?",
    "options": ["국내", "해외"]
}
데이터 구조가 맞지 않으므로 문제가 발생합니다.
이런 문제를 방지하기 위해 Pydantic을 사용합니다.
3-1. Pydantic이란?
Pydantic: Python 데이터 검증 및 직렬화 라이브러리. 쉽게 말하면 Pydantic은 우리가 정해 놓은 데이터 형식에 맞게 데이터가 들어왔는지 검사하고, 필요한 형태로 변환해 주는 라이브러리입니다.
예를 들어 다음과 같은 규칙을 만들 수 있습니다.
-
질문은 문자열이어야 한다.
-
선택지는 최소 2개, 최대 4개여야 한다.
-
전체 질문은 최대 3개여야 한다.
-
Research Brief에는 제목, 목적, 범위가 반드시 있어야 한다.
이런 규칙을 Python 코드로 정의하는 것입니다.
3-2. Pydantic 기본 구조
먼저 다음 두 줄을 보겠습니다.
from pydantic import BaseModel, FieldBaseModel은 Pydantic 모델을 만들기 위한 기본 클래스입니다.
Field는 개별 필드에 대한 설명, 제약 조건, 기본값 등을 지정할 때 사용합니다.
일반적인 Python 클래스와 비교해 보겠습니다.
일반적인 클래스:
class Person:

    def __init__(self, name, age):
        self.name = name
        self.age = age
Pydantic 클래스:
class Person(BaseModel):

    name: str
    age: int
Pydantic에서는 자료형을 선언하면 입력값의 검증과 변환을 자동으로 처리합니다.
예를 들어:
person = Person(
    name="Steven",
    age=30
)
이렇게 생성할 수 있습니다.
다음과 같이 잘못된 자료형이 들어오면 Pydantic이 변환을 시도하거나 검증 오류를 발생시킵니다.
person = Person(
    name="Steven",
    age="abc"
)abc는 정수로 변환할 수 없으므로 검증 오류가 발생합니다.
3-3. QuestionOption 클래스
class QuestionOption(BaseModel):

    id: str = Field(
        description="선택지 식별자. 예: a, b, c"
    )

    text: str = Field(
        description="사용자에게 보여줄 선택지 내용"
    )
이 클래스는 하나의 질문에 속하는 개별 선택지를 정의합니다.
예를 들어 Planner Agent가 다음 질문을 만들었다고 가정하겠습니다.
"한국 AI 시장에서 어떤 분야를 중점적으로 조사할까요?"
선택지는 다음과 같습니다.
-
a: 생성형 AI
-
b: AI 반도체
-
c: AI 서비스 및 플랫폼
이 선택지를 표현하기 위한 데이터 구조입니다.
먼저:
class QuestionOption(BaseModel):QuestionOption이라는 이름의 Pydantic 모델을 생성합니다.
여기서 class는 Python의 클래스를 선언하는 문법입니다.
BaseModel을 상속했으므로 Pydantic의 데이터 검증 기능을 사용할 수 있습니다.
다음:
id: strid는 선택지 식별자입니다.
자료형은 str, 즉 문자열입니다.
왜 ID가 필요할까요?
사용자가 다음과 같이 답변할 수 있기 때문입니다.
1-a, 2-b, 3-c여기서 a, b, c가 선택지의 ID입니다.
그리고:
text: str실제 사용자에게 보여줄 선택지 내용을 저장합니다.
예를 들어 다음과 같은 데이터가 됩니다.
QuestionOption(
    id="a",
    text="생성형 AI 시장"
)
이것을 딕셔너리로 변환하면:
{
    "id": "a",
    "text": "생성형 AI 시장"
}
가 됩니다.
즉, QuestionOption은 하나의 선택지를 표현하는 가장 작은 데이터 단위입니다.
3-4. ClarifyingQuestion 클래스
class ClarifyingQuestion(BaseModel):

    question: str = Field(
        description="리서치 범위를 구체화하기 위한 질문"
    )

    options: list[QuestionOption] = Field(
        min_length=2,
        max_length=4,
        description="사용자가 선택할 수 있는 2~4개 선택지"
    )

    rationale: str = Field(
        description="이 질문을 하는 이유"
    )
이번에는 하나의 질문과 그 질문에 대한 선택지를 함께 정의합니다.
앞에서 QuestionOption은 하나의 선택지였습니다.
이번 ClarifyingQuestion은 질문 하나와 여러 선택지를 묶는 구조입니다.
① question
question: str실제 질문 내용입니다.
예를 들어:
한국 AI 시장 중 어떤 분야를 집중적으로 조사할까요?② options
options: list[QuestionOption]여기서 중요한 것은 list[QuestionOption]입니다.
이것은 QuestionOption 객체를 여러 개 담을 수 있는 리스트라는 뜻입니다.
예를 들어:
options = [
    QuestionOption(
        id="a",
        text="생성형 AI"
    ),
    QuestionOption(
        id="b",
        text="AI 반도체"
    ),
    QuestionOption(
        id="c",
        text="AI 플랫폼"
    )
]
이렇게 구성할 수 있습니다.
여기서:
min_length=2,
max_length=4,
는 리스트의 최소 길이와 최대 길이를 지정합니다.
따라서 선택지는 2개 이상 4개 이하이어야 합니다.
1개만 있거나 5개가 있으면 Pydantic 검증에서 거부됩니다.
이렇게 해두면 LLM이 질문을 생성할 때 선택지 개수에 대한 제약도 함께 적용할 수 있습니다.
③ rationale
rationale: str질문을 하는 이유입니다.
예를 들어:
조사 대상 분야에 따라 시장 규모, 주요 기업, 기술 동향이 달라지기 때문입니다.이 정보는 사용자가 질문의 의도를 이해하는 데 도움이 됩니다.
④ 전체 데이터 예시
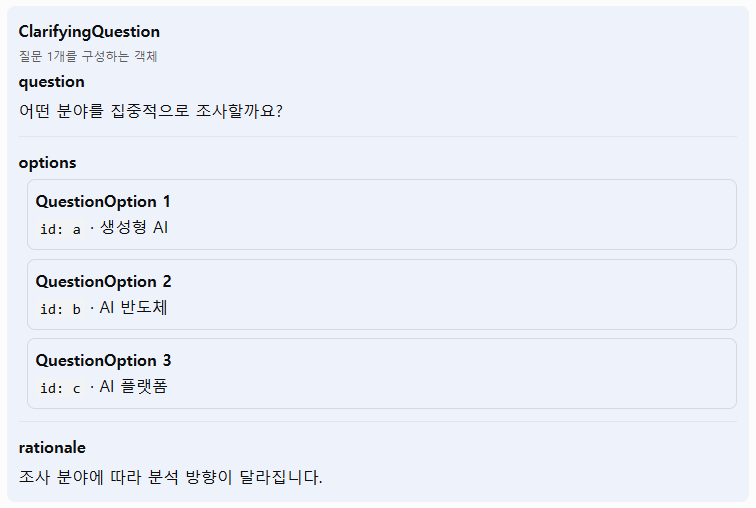
이 세 가지를 합치면 다음과 같습니다.
question = ClarifyingQuestion(

    question="어떤 분야를 집중적으로 조사할까요?",

    options=[
        QuestionOption(
            id="a",
            text="생성형 AI"
        ),
        QuestionOption(
            id="b",
            text="AI 반도체"
        ),
        QuestionOption(
            id="c",
            text="AI 플랫폼"
        )
    ],

    rationale="조사 대상에 따라 시장 분석 방향이 달라집니다."
)
구조를 그림으로 표현하면 다음과 같습니다.
3-5. ClarifyingQuestions 클래스
class ClarifyingQuestions(BaseModel):

    questions: list[ClarifyingQuestion] = Field(
        min_length=1,
        max_length=3,
        description="최대 3개의 핵심 명확화 질문"
    )
이번에는 질문 하나가 아니라 질문 전체를 관리하는 클래스입니다.
앞에서 설명한 구조를 다시 정리하면 다음과 같습니다.
-
QuestionOption: 선택지 하나
-
ClarifyingQuestion: 질문 하나와 그 질문의 선택지들
-
ClarifyingQuestions: 질문 여러 개를 모은 전체 묶음
이것은 계층적인 데이터 구조입니다.
예를 들어 다음과 같은 데이터를 표현할 수 있습니다.
clarifying_questions = ClarifyingQuestions(

    questions=[

        ClarifyingQuestion(
            question="조사 대상 지역은 어디인가요?",
            options=[
                QuestionOption(
                    id="a",
                    text="한국"
                ),
                QuestionOption(
                    id="b",
                    text="미국"
                ),
                QuestionOption(
                    id="c",
                    text="글로벌"
                )
            ],
            rationale="지역에 따라 시장 규모와 기업 구성이 달라집니다."
        ),

        ClarifyingQuestion(
            question="조사 기간은 어떻게 할까요?",
            options=[
                QuestionOption(
                    id="a",
                    text="최근 1년"
                ),
                QuestionOption(
                    id="b",
                    text="최근 3년"
                ),
                QuestionOption(
                    id="c",
                    text="향후 5년 전망 포함"
                )
            ],
            rationale="분석 기간에 따라 시장 전망의 범위가 달라집니다."
        )
    ]
)
여기서:
questions: list[ClarifyingQuestion]질문 객체를 여러 개 담는 리스트입니다.
그리고:
min_length=1,
max_length=3,
최소 1개, 최대 3개의 질문을 허용합니다.
따라서 Planner Agent가 최대 3개의 명확화 질문을 반환하도록 데이터 구조 자체에 제한을 설정한 것입니다.
3-6. ResearchBrief 클래스
이제 가장 중요한 데이터 구조입니다.
class ResearchBrief(BaseModel):

    title: str = Field(
        description="리서치 프로젝트 제목"
    )

    objective: str = Field(
        description="리서치의 목적"
    )

    scope: str = Field(
        description="리서치의 구체적인 범위"
    )

    key_questions: list[str] = Field(
        min_length=3,
        max_length=5,
        description="리서치에서 답변해야 할 핵심 질문"
    )

    constraints: list[str] = Field(
        default_factory=list,
        description="리서치의 제약 조건"
    )

    expected_output: str = Field(
        description="최종적으로 기대하는 결과물"
    )
Research Brief는 Researcher가 어떤 조사를 해야 하는지 알려주는 일종의 조사 지시서입니다.
실제 회사에서 리서치 프로젝트를 수행한다고 생각해 보겠습니다.
담당자가 조사 업무를 지시할 때 단순히 다음과 같이 이야기하지는 않을 것입니다.
"AI 시장을 조사해 주세요."
대신 다음 내용을 정리할 것입니다.
-
무엇을 조사하는가?
-
왜 조사하는가?
-
어디까지 조사하는가?
-
어떤 질문에 답해야 하는가?
-
어떤 제약이 있는가?
-
최종 결과물은 무엇인가?
이것이 바로 Research Brief의 역할입니다.
각 항목을 살펴보겠습니다.
① title
title: str리서치 프로젝트의 제목입니다.
예를 들면:
2026~2030년 한국 생성형 AI 시장 전망 및 사업 기회 분석② objective
objective: str조사 목적입니다.
예를 들어:
국내 생성형 AI 시장의 성장 가능성과 주요 사업 기회를 파악하고,
신규 사업 추진을 위한 전략적 판단 근거를 확보한다.
제목과 목적은 다릅니다.
제목은 무엇을 조사하는지 표현하고, 목적은 왜 조사하는지를 설명합니다.
③ scope
scope: str조사 범위를 지정합니다.
예를 들어:
국내 공공 및 기업 시장을 중심으로 생성형 AI 솔루션,
AI 인프라, 주요 공급기업 및 사업 모델을 조사한다.
2024~2026년 시장 현황과 2030년까지의 전망을 포함한다.
조사 범위를 명확히 해야 Researcher가 불필요한 검색을 줄일 수 있습니다.
④ key_questions
key_questions: list[str] = Field(
    min_length=3,
    max_length=5,
    description="리서치에서 답변해야 할 핵심 질문"
)
여기서는 list[str]을 사용했습니다.
앞서 질문 선택지에서는 list[QuestionOption]을 사용했는데, 이번에는 문자열 자체를 리스트에 넣습니다.
예를 들어:
key_questions = [
    "국내 생성형 AI 시장 규모는 얼마나 되는가?",
    "주요 경쟁 기업과 제품은 무엇인가?",
    "공공 및 기업 시장의 성장 요인은 무엇인가?",
    "향후 5년간 유망한 사업 분야는 무엇인가?"
]
여기서 3개 이상 5개 이하라는 제한이 있습니다.
이것은 Researcher가 반드시 답해야 할 조사 질문의 개수를 통제하기 위한 것입니다.
⑤ constraints
constraints: list[str] = Field(
    default_factory=list,
    description="리서치의 제약 조건"
)
이 부분은 조금 더 주의 깊게 살펴보겠습니다.
default_factory=list는 해당 필드에 아무런 값도 지정하지 않았을 때 빈 리스트를 기본값으로 사용한다는 의미입니다.
예를 들어:
brief = ResearchBrief(
    title="한국 AI 시장 분석",
    objective="시장 기회 파악",
    scope="한국 시장",
    key_questions=[
        "시장 규모는?",
        "주요 기업은?",
        "성장 가능성은?"
    ],
    expected_output="시장 분석 보고서"
)
여기서는 constraints를 입력하지 않았습니다.
그렇더라도 오류가 발생하지 않습니다.
자동으로 다음과 같이 처리됩니다.
constraints=[]왜 default_factory=list를 사용할까요?
다음과 같이 작성하는 것과 비교해 보겠습니다.
constraints: list[str] = []Python에서 변경 가능한 객체인 리스트를 기본값으로 직접 공유하는 방식은 피하는 것이 좋습니다.
default_factory=list는 객체를 생성할 때마다 새로운 빈 리스트를 만들어 줍니다.
따라서 여러 ResearchBrief 객체가 서로의 제약 조건 리스트를 공유하는 문제를 방지합니다.
⑥ expected_output
expected_output: str최종적으로 어떤 결과물을 원하는지를 명시합니다.
예를 들어:
시장 규모, 경쟁사 비교, 기술 동향, 사업 기회 및 전략적 제언을 포함한 전문적인 Markdown 보고서Researcher는 이 내용을 참고하고 Writer는 최종 보고서의 구성과 완성도를 판단하는 데 활용할 수 있습니다.
3-7. Pydantic 데이터가 실제로 ADK에서 사용되는 과정
이제 중요한 연결 관계를 살펴보겠습니다.
Planner Agent에서 다음과 같이 설정했습니다.
questions_agent = Agent(

    name="questions_generator",

    model=MODEL_ID,

    instruction=QUESTION_PROMPT,

    output_schema=ClarifyingQuestions,

    output_key="clarifying_questions",
)
여기서 두 가지가 중요합니다.
첫째, output_schema=ClarifyingQuestions
LLM이 반환해야 하는 결과의 구조를 지정합니다.
즉, 질문을 일반적인 자연어로 반환하는 것이 아니라 ClarifyingQuestions의 데이터 구조에 맞게 반환하도록 유도하고 검증하는 역할을 합니다.
둘째, output_key="clarifying_questions"
에이전트가 생성한 결과를 ADK 세션 상태에 저장할 때 사용할 키입니다.
예를 들어 다음과 같은 형태로 저장됩니다.
session.state["clarifying_questions"]이후 Workflow나 다른 에이전트에서 이 데이터를 활용할 수 있습니다.
다음 단계에서는 ClarifyingQuestions 객체를 일반 Python 딕셔너리로 변환할 수도 있습니다.
questions.model_dump()그 결과는 다음과 같은 구조입니다.
{
    "questions": [
        {
            "question": "조사 대상 지역은 어디인가요?",
            "options": [
                {
                    "id": "a",
                    "text": "한국"
                },
                {
                    "id": "b",
                    "text": "미국"
                }
            ],
            "rationale": "지역에 따라 시장이 달라집니다."
        }
    ]
}
이처럼 Pydantic은 구조화된 데이터를 만들고, ADK는 그 데이터를 세션 상태에 저장하여 다음 단계로 전달하는 역할을 합니다.
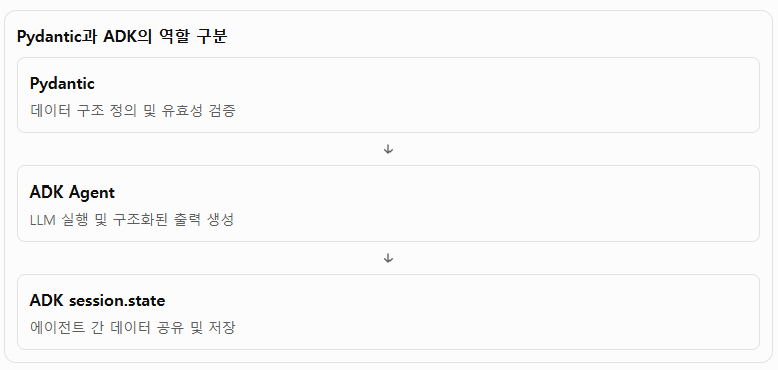
여기서 한 가지 구분해야 합니다. output_schema가 있다고 해서 모든 데이터가 자동으로 영구 저장되는 것은 아닙니다. output_key가 저장을 담당하고, 실제 저장 범위와 지속성은 ADK의 SessionService 설정에 따라 달라집니다.
4. deep_research/tools/tavily_search.py 상세 해설
이제 세 번째 파일입니다.
이 파일은 앞의 두 파일과 성격이 조금 다릅니다.
config.py는 설정을 관리하고, schemas.py는 데이터 구조를 정의했습니다.
반면 tavily_search.py는 실제 외부 서비스와 통신하여 일을 수행하는 **실행 가능한 도구(Tool)**입니다.
여기서 우리가 이해해야 할 핵심은 다음 세 가지입니다.
-
Tavily는 어떤 서비스이고 Python에서 어떻게 호출하는가?
-
Google ADK는 일반 Python 함수를 어떻게 AI Agent의 Tool로 사용하는가?
-
ToolContext와 session.state를 이용해서 검색 횟수를 어떻게 관리하는가?
4-1. Tavily란 무엇인가?
Tavily: AI 에이전트를 위한 웹 검색 API 서비스. 일반적인 웹 검색을 생각해 보겠습니다. 사람은 Google이나 Bing에서 검색어를 입력하고 검색 결과를 확인합니다.
그런데 AI Agent가 직접 검색하려면 어떻게 해야 할까요?
LLM 자체는 기본적으로 인터넷을 직접 탐색하는 기능이 없습니다. 외부 검색 서비스나 검색 도구를 연결해 주어야 합니다.
Tavily가 바로 이 역할을 합니다.
예를 들어 Research Agent가 다음과 같은 검색을 수행한다고 가정하겠습니다.
2026년 한국 생성형 AI 시장 규모 및 성장 전망Tavily는 이 검색어를 받아 웹 검색을 수행하고, 검색 결과의 제목, URL, 내용 등의 정보를 반환합니다.
그 결과를 다시 Gemini에게 전달하면 Gemini가 해당 자료를 분석할 수 있습니다.
즉, 역할은 다음과 같이 나뉩니다.
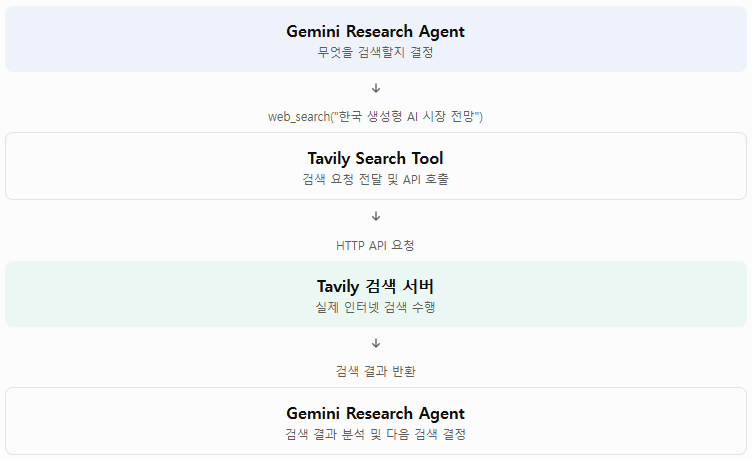
여기서 반드시 기억해야 할 점이 있습니다.
검색어를 결정하고 검색 결과를 분석하는 것은 Gemini이고, 실제 웹 검색을 수행하는 것은 Tavily입니다.
4-2. 모듈과 라이브러리 가져오기
import json
import os

from tavily import TavilyClient
from google.adk.tools import ToolContext

from ..config import MAX_SEARCH_CALLS, SEARCH_MAX_RESULTS
각각 살펴보겠습니다.
① json
import jsonPython의 JSON 처리 라이브러리입니다.
JSON은 서로 다른 프로그램이나 시스템 사이에서 데이터를 주고받을 때 널리 사용하는 데이터 형식입니다.
예를 들어 다음과 같은 데이터가 있다고 가정하겠습니다.
result = {
    "title": "한국 AI 시장 전망",
    "url": "https://example.com",
    "score": 0.95
}
이것은 Python의 딕셔너리입니다.
이를 JSON 문자열로 바꾸려면 다음과 같이 합니다.
json.dumps(result)결과:
{"title": "한국 AI 시장 전망", "url": "https://example.com", "score": 0.95}여기서 dumps()는 Python 객체를 JSON 문자열로 변환하는 함수입니다.
이 코드에서는 Tavily의 검색 결과를 정리한 다음 JSON 문자열로 만들어 Research Agent에 반환하는 데 사용합니다.
참고로:
-
json.dumps(): Python 객체 → JSON 문자열
-
json.loads(): JSON 문자열 → Python 객체
이 차이를 기억하시면 됩니다.
② os
import os운영체제 환경변수를 읽기 위해 사용합니다.
이 파일에서는 다음 부분에 사용됩니다.
api_key = os.getenv("TAVILY_API_KEY").env에 저장된 Tavily API Key를 가져오는 것입니다.
앞에서 config.py가 load_dotenv()를 실행했기 때문에 환경변수에 접근할 수 있습니다.
③ TavilyClient
from tavily import TavilyClientTavily에서 제공하는 Python SDK의 클라이언트 클래스입니다.
클라이언트(Client)는 외부 서비스와 통신하기 위한 연결 객체라고 이해하시면 됩니다.
우리가 웹 브라우저를 이용해서 Tavily 웹사이트에 직접 접속하는 대신 Python 코드에서 API를 호출할 수 있도록 해주는 인터페이스입니다.
④ ToolContext
from google.adk.tools import ToolContext이 부분은 ADK를 이해할 때 상당히 중요합니다.
ToolContext는 ADK가 Tool을 실행할 때 도구 함수에 전달해 주는 실행 컨텍스트입니다.
쉽게 말하면 도구가 현재 어떤 에이전트 실행 환경에서 동작하고 있는지, 어떤 세션 상태를 이용할 수 있는지 등에 접근할 수 있게 해주는 객체입니다.
예를 들어:
tool_context.state를 통해 현재 세션의 상태를 읽고 수정할 수 있습니다.
일반적인 Python 함수에는 없는 기능입니다. ADK가 실행 컨텍스트를 제공하기 때문에 가능한 것입니다.
⑤ 상대 경로 import
from ..config import MAX_SEARCH_CALLS, SEARCH_MAX_RESULTS여기서 ..는 현재 패키지의 상위 패키지를 의미합니다.
현재 파일의 위치는 다음과 같습니다.
deep_research/
    config.py
    tools/
tavily_search.pytools에서 한 단계 위로 올라가면 deep_research입니다.
따라서 다음 두 변수를 가져오는 것입니다.
MAX_SEARCH_CALLS = 6
SEARCH_MAX_RESULTS = 5
이렇게 설정을 가져오면 검색 도구에서 숫자를 직접 반복해서 작성하지 않아도 됩니다.
5. web_search() 함수의 상세 해설
이제 실제 핵심 함수입니다.
def web_search(
    query: str,
    tool_context: ToolContext,
) -> str:
먼저 함수 선언을 이해해 보겠습니다.
def는 Python에서 함수를 정의할 때 사용하는 예약어입니다.
함수 이름은 web_search입니다.
괄호 안에는 두 개의 매개변수가 있습니다.
| 매개변수 | 자료형 | 역할 |
| query | str | 검색할 검색어 |
| tool_context | ToolContext | ADK 실행 컨텍스트 |
마지막의:
-> str은 함수가 문자열을 반환한다는 타입 힌트입니다.
실제로 반환하는 값은 JSON 형식으로 직렬화된 문자열입니다.
5-1. query란 무엇인가?
query: str검색어입니다.
예를 들어 Research Agent가 다음과 같이 판단했다고 가정하겠습니다.
"한국 AI 시장의 성장 규모를 알아봐야겠다."
그러면 LLM이 검색어를 결정합니다.
query = "2026년 한국 생성형 AI 시장 규모 성장률 전망"이 검색어가 web_search()에 전달됩니다.
여기서 흥미로운 점은 사람이 직접 검색어를 입력하는 것이 아니라는 점입니다.
Research Agent가 자신의 리서치 목표를 이해한 다음 검색어를 스스로 결정한다는 것입니다.
이것이 일반적인 검색 프로그램과 AI Agent의 중요한 차이입니다.
5-2. tool_context란 무엇인가?
tool_context: ToolContext이 매개변수는 ADK가 제공하는 실행 컨텍스트입니다.
일반적인 함수 호출이라면 다음과 같을 것입니다.
web_search("한국 AI 시장 전망")그런데 현재 함수는 다음과 같이 매개변수가 두 개입니다.
web_search(
    query="한국 AI 시장 전망",
    tool_context=...
)
여기서 중요한 것은 실제 AI Agent가 호출할 때 tool_context를 사용자가 직접 입력하는 것이 아니라는 점입니다.
ADK는 ToolContext를 지원하는 도구 함수의 실행 시점에 적절한 컨텍스트를 주입합니다.
따라서 Gemini에게 노출되는 핵심 검색 인자는 query입니다.
이것은 ADK가 Python 함수의 매개변수와 타입 힌트를 바탕으로 Tool의 입력 스키마를 구성하는 기능과 연결됩니다.
6. 검색 횟수 확인
이제 다음 코드입니다.
search_count = tool_context.state.get(
    "temp:search_call_count", 0
)
여기는 ADK의 상태 관리 기능을 활용하는 부분입니다.
먼저 tool_context.state부터 이해해 보겠습니다.
6-1. tool_context.state
tool_context.state는 현재 ADK 실행 환경의 상태 데이터에 접근하는 객체입니다.
일반적인 Python 딕셔너리처럼 사용할 수 있습니다.
예를 들어:
tool_context.state["name"] = "Steven"이렇게 값을 저장할 수 있습니다.
그리고 다음과 같이 읽을 수 있습니다.
name = tool_context.state.get("name")즉, 다음과 같은 딕셔너리 구조를 생각하면 됩니다.
state = {
    "original_request": "한국 AI 시장 분석",
    "user_responses": "국내 시장, 향후 5년",
    "search_call_count": 3
}
물론 실제 ADK에서는 단순한 일반 딕셔너리보다 상태 변경과 저장 범위에 대한 기능이 추가되어 있습니다.
6-2. get() 메서드
search_count = tool_context.state.get(
    "temp:search_call_count", 0
)
Python 딕셔너리의 get()은 특정 키에 해당하는 값을 가져오는 메서드입니다.
첫 번째 인수는 키이고, 두 번째 인수는 해당 키가 없을 때 반환할 기본값입니다.
예를 들어:
data = {
    "name": "Steven"
}

print(data.get("name", "Unknown"))
결과:
Steven반면:
print(data.get("age", 0))결과:
0age라는 키가 없으므로 기본값인 0을 반환합니다.
우리 코드에서는 다음과 같은 의미입니다.
-
검색 횟수가 이미 저장되어 있다면 그 값을 가져온다.
-
처음 검색하는 경우에는 0을 사용한다.
6-3. temp:라는 접두어의 의미
여기서 가장 중요한 부분이 나옵니다.
"temp:search_call_count"일반적인 상태 키는 다음과 같이 사용합니다.
"search_call_count"그런데 앞에 temp:를 붙였습니다.
ADK에서는 상태 키에 접두어를 사용하여 상태의 범위를 구분할 수 있습니다.
| 접두어 | 의미 |
| app: | 애플리케이션 범위 |
| user: | 사용자 범위 |
| temp: | 현재 Invocation의 임시 상태 |
| 접두어 없음 | 현재 세션 범위 |
여기서 Invocation은 ADK에서 사용자의 요청 하나를 처리하는 실행 단위라고 이해하시면 됩니다.
예를 들어 사용자가 한 번의 리서치 요청을 실행하면 하나의 Invocation이 발생합니다.
그 안에서 Research Agent가 여러 차례 검색을 수행할 수 있습니다.
temp:를 사용하는 이유는 검색 횟수를 해당 실행 과정 안에서 관리하기 위해서입니다.
중요한 차이를 비교해 보겠습니다.
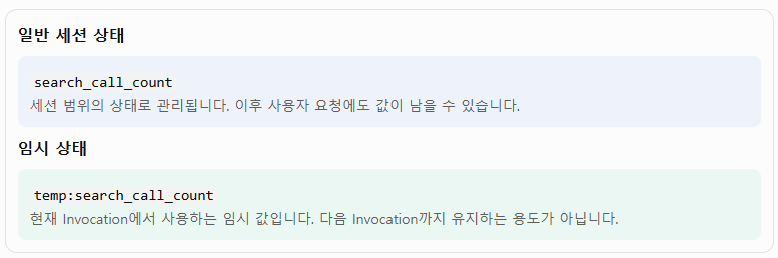
따라서 이번 프로젝트에서는 검색 횟수를 현재 리서치 실행 단위에 맞춰 관리하려는 것입니다.
이것은 적절한 설계입니다.
6-4. 검색 한도 초과 여부 확인
if search_count >= MAX_SEARCH_CALLS:
    return json.dumps(
        {
            "error": "검색 호출 한도에 도달했습니다.",
            "max_search_calls": MAX_SEARCH_CALLS,
        },
        ensure_ascii=False,
    )
이제 실제 제한을 확인합니다.
앞서 config.py에서 다음과 같이 설정했습니다.
MAX_SEARCH_CALLS = 6따라서:
if search_count >= MAX_SEARCH_CALLS:는 검색 횟수가 6 이상인지 확인하는 조건문입니다.
예를 들어 다음과 같습니다.
| 현재 검색 횟수 | 검색 허용 여부 |
| 0 | 허용 |
| 1 | 허용 |
| 2 | 허용 |
| 3 | 허용 |
| 4 | 허용 |
| 5 | 허용 |
| 6 | 차단 |
| 7 | 차단 |
검색 횟수가 6회에 도달했다면 더 이상 검색을 수행하지 않습니다.
return의 의미
return json.dumps(...)return은 현재 함수를 즉시 종료하고 결과를 호출한 쪽으로 반환하는 명령입니다.
따라서 검색 한도에 도달하면 아래에 있는 Tavily API 호출 부분까지 실행하지 않습니다.
ensure_ascii=False
ensure_ascii=False이것은 JSON 문자열을 만들 때 한글을 어떻게 표현할지 결정합니다.
예를 들어:
import json

data = {"error": "검색 횟수 초과"}

print(json.dumps(data))
기본 설정에서는 한글이 다음처럼 유니코드 이스케이프 형태로 표시될 수 있습니다.
{"error": "\uac80\uc0c9 \ud69f\uc218 \ucd08\uacfc"}반면:
print(
    json.dumps(
        data,
        ensure_ascii=False
    )
)
결과:
{"error": "검색 횟수 초과"}사람이 읽기 쉬운 형태가 됩니다.
AI Agent가 JSON을 해석하는 데 필수적인 설정은 아니지만, 디버깅과 로그 확인에는 훨씬 편리합니다.
6-5. 검색 횟수 증가
tool_context.state["temp:search_call_count"] = (
    search_count + 1
)
이 코드는 검색 횟수를 1 증가시키는 부분입니다.
예를 들어 현재 검색 횟수가 2라면:
search_count = 2다음 코드가 실행되면:
tool_context.state["temp:search_call_count"] = 3상태가 변경됩니다. 다음 검색 호출에서는 이 값을 읽어 3으로 인식하게 됩니다.
여기서 주목할 점이 있습니다.
검색 횟수를 증가시키는 시점은 실제 검색을 성공한 이후가 아니라 검색을 시도하기 직전입니다.
따라서 API 키가 없거나 검색어가 비어 있거나 Tavily 호출이 실패하더라도 호출 횟수는 증가합니다.
이 코드는 엄밀하게 말하면 성공한 검색 횟수가 아니라 검색 도구 호출 시도 횟수를 관리합니다.
API 사용량을 제한하고 싶다면 이런 방식이 합리적일 수 있습니다.
7. 검색어 검증
query = query.strip()

if not query:
    return json.dumps(
        {"error": "검색어가 비어 있습니다."},
        ensure_ascii=False,
    )
① strip()
strip()은 문자열의 앞뒤에 있는 공백 문자를 제거합니다.
예를 들어:
query = "   한국 AI 시장 전망   "

query = query.strip()

print(query)
결과:
한국 AI 시장 전망검색어의 앞뒤에 불필요한 공백이 들어가는 것을 방지합니다.
② if not query
이것은 검색어가 비어 있는지 확인하는 조건문입니다.
예를 들어:
query = ""또는:
query = " "이 경우 strip()을 실행하면 빈 문자열이 됩니다.
Python에서는 빈 문자열을 조건문에서 False로 취급합니다.
따라서:
if not query:는 검색어가 비어 있으면 참이 됩니다.
이 경우 Tavily에 검색 요청을 보내지 않고 오류 메시지를 반환합니다.
이런 검증을 입력값 검증(Input Validation)이라고 합니다.
8. Tavily API Key 확인
api_key = os.getenv("TAVILY_API_KEY")

if not api_key:
    return json.dumps(
        {"error": "TAVILY_API_KEY가 설정되지 않았습니다."},
        ensure_ascii=False,
    )
이 코드는 Tavily에 접속하기 위한 인증 키가 있는지 확인합니다.
Tavily API는 인증을 거쳐야 사용할 수 있습니다.
따라서 API Key가 없으면 정상적인 검색이 불가능합니다.
앞에서 .env에 다음과 같이 설정했습니다.
TAVILY_API_KEY=tvly-xxxxxxxxos.getenv()가 이 값을 읽어옵니다.
그리고:
if not api_key:키가 없거나 빈 문자열이면 오류 메시지를 반환합니다.
이렇게 API Key를 확인하는 이유는 다음과 같습니다.
-
인증되지 않은 API 호출 방지
-
불필요한 예외 발생 방지
-
사용자가 문제를 쉽게 파악할 수 있도록 안내
다만 현재 코드에서는 config.py에 이미 TAVILY_API_KEY를 정의했는데 다시 os.getenv()로 읽고 있습니다.
동작에는 문제가 없지만, 설정을 중앙집중화한다는 설계 관점에서는 개선할 수 있습니다. 이 부분은 마지막 개선 코드에서 다시 설명하겠습니다.
9. Tavily 실제 검색 수행
이제 실제 웹 검색을 수행하는 부분입니다.
try:

    tavily_client = TavilyClient(
        api_key=api_key
    )

    response = tavily_client.search(
        query=query,
        search_depth="advanced",
        max_results=SEARCH_MAX_RESULTS,
    )
여기서부터 실제 외부 API를 호출합니다.
9-1. try
try:Python에서 예외가 발생할 수 있는 코드를 감싸는 구문입니다.
외부 API를 호출하면 여러 가지 오류가 발생할 수 있습니다.
-
인터넷 연결 오류
-
API 인증 오류
-
사용량 초과
-
서버 오류
-
응답 처리 오류
이런 오류가 발생하더라도 프로그램이 무조건 중단되지 않도록 try-except 구조를 사용하는 것입니다.
9-2. TavilyClient 생성
tavily_client = TavilyClient(
    api_key=api_key
)
Tavily 서비스를 이용하기 위한 클라이언트 객체를 생성합니다.
여기서 API Key를 전달합니다.
이제 tavily_client라는 객체를 통해 Tavily의 여러 기능을 호출할 수 있습니다.
쉽게 말하면 외부 검색 서비스와 통신하기 위한 연결 도구를 준비하는 것입니다.
9-3. search() 실행
response = tavily_client.search(
    query=query,
    search_depth="advanced",
    max_results=SEARCH_MAX_RESULTS,
)
이 부분이 실제 검색 요청입니다.
각 매개변수를 살펴보겠습니다.
| 매개변수 | 의미 | 현재 설정 |
| query | 검색어 | Gemini가 생성 |
| search_depth | 검색 깊이 | advanced |
| max_results | 최대 검색 결과 수 | 5 |
query=query
앞에서 검증한 검색어를 전달합니다.
예를 들어:
2026년 한국 생성형 AI 시장 규모
search_depth="advanced"
Tavily에 고급 검색 깊이를 요청합니다.
일반적인 검색보다 심층적인 검색을 수행하도록 설정한 것입니다. 다만 실제 검색 품질과 결과는 Tavily 서비스의 검색 정책과 응답에 따라 달라집니다.
max_results=SEARCH_MAX_RESULTS
한 번의 검색에서 가져올 최대 결과 수입니다.
config.py에서 5로 설정했으므로 최대 5개의 결과를 요청합니다.
response
검색이 완료되면 Tavily가 반환한 응답 데이터가 저장됩니다.
개념적으로는 다음과 같은 구조라고 생각하시면 됩니다.
response = {
    "query": "한국 생성형 AI 시장 규모",
    "results": [
        {
            "title": "한국 AI 시장 전망",
            "url": "https://example.com/article1",
            "content": "한국 AI 시장은...",
            "score": 0.95
        },
        {
            "title": "생성형 AI 시장 분석",
            "url": "https://example.com/article2",
            "content": "생성형 AI 시장은...",
            "score": 0.91
        }
    ]
}
실제 Tavily 응답은 더 많은 필드를 포함할 수 있습니다.
여기서 response는 일반적으로 Python 딕셔너리 형태로 다룰 수 있습니다.
10. 검색 결과 정리
이제 검색 결과를 Research Agent가 활용하기 좋은 형태로 가공합니다.
results = []빈 리스트를 하나 만듭니다.
이 리스트에 검색 결과를 하나씩 추가할 것입니다.
다음 코드를 보겠습니다.
for item in response.get("results", []):

    results.append(
        {
            "title": item.get("title", ""),
            "url": item.get("url", ""),
            "content": item.get("content", "")[:2000],
            "score": item.get("score"),
            "published_date": item.get(
                "published_date"
            ),
        }
    )
이 코드는 이번 파일에서 Python 자료구조를 이해하는 데 매우 좋은 예제입니다.
10-1. for 반복문
for item in response.get("results", []):검색 결과가 여러 개이므로 하나씩 꺼내서 처리합니다.
예를 들어 Tavily에서 5개의 검색 결과를 반환했다고 가정하겠습니다.
response["results"]이 리스트에는 5개의 검색 결과가 들어 있습니다.
for문은 다음과 같이 동작합니다.
-
첫 번째 검색 결과를 item에 저장
-
필요한 정보를 추출하여 results에 추가
-
두 번째 검색 결과 처리
-
세 번째 검색 결과 처리
-
모든 결과를 처리할 때까지 반복
response.get("results", [])
여기서도 get()을 사용합니다.
response.get("results", [])results라는 키가 있으면 그 값을 가져오고, 없으면 빈 리스트를 반환합니다.
이렇게 하면 검색 결과가 없는 경우에도 반복문이 안전하게 실행됩니다.
10-2. results.append()
results.append(
    {
        ...
    }
)append()는 리스트에 새로운 요소를 추가하는 메서드입니다.
예를 들어:
results = []

results.append("검색 결과 1")
results.append("검색 결과 2")
결과:
[
    "검색 결과 1",
    "검색 결과 2"
]
우리 코드에서는 문자열 대신 딕셔너리를 추가합니다.
따라서 최종적으로는 다음과 같은 리스트가 됩니다.
results = [
    {
        "title": "한국 AI 시장 전망",
        "url": "https://example.com/1",
        "content": "한국 AI 시장은...",
        "score": 0.95,
        "published_date": None
    },
    {
        "title": "생성형 AI 분석",
        "url": "https://example.com/2",
        "content": "생성형 AI는...",
        "score": 0.91,
        "published_date": None
    }
]
10-3. 각 필드 해설
title
"title": item.get("title", "")검색 결과의 제목을 가져옵니다.
제목이 없으면 빈 문자열을 사용합니다.
url
"url": item.get("url", "")검색 결과의 원문 URL입니다.
최종 보고서에서 참고 출처를 작성할 때 중요한 정보입니다.
content
"content": item.get("content", "")[:2000]검색 결과의 내용을 가져옵니다.
여기서 [:2000]이 중요합니다.
Python의 문자열 슬라이싱입니다.
문자열에서 처음부터 2,000번째 문자까지 잘라낸다는 뜻입니다.
왜 2,000자로 제한할까요?
검색 결과를 무제한으로 가져오면 LLM에 전달하는 토큰이 지나치게 많아질 수 있기 때문입니다.
따라서 검색 결과의 길이를 적절히 제한하는 것입니다.
다만 2,000자는 글자 수 기준이지 토큰 수 기준은 아닙니다.
한국어와 영어는 토큰화 결과가 다르므로 실제 토큰 사용량은 달라집니다.
score
"score": item.get("score")Tavily가 제공하는 검색 관련성 점수입니다.
일반적으로 검색 결과의 관련성을 판단하는 데 참고할 수 있습니다.
다만 이 점수는 정보의 진실성이나 출처의 신뢰도를 직접 보증하는 점수는 아닙니다.
예를 들어 검색 관련성 점수가 0.95라고 해서 해당 문서의 내용이 95% 정확하다는 의미는 아닙니다.
published_date
"published_date": item.get(
    "published_date"
)
검색 결과의 게시 날짜 정보를 가져옵니다.
검색 결과에 이 값이 존재하면 저장하고, 없으면 None을 반환합니다.
이 값은 최신 자료를 판단할 때 참고할 수 있습니다.
단, 모든 검색 결과에 게시 날짜가 제공되는 것은 아닙니다.
11. 검색 결과 전체 데이터 구성
이제 정리한 검색 결과를 하나의 딕셔너리로 묶습니다.
result_data = {
    "query": query,
    "search_count": search_count + 1,
    "total_results": len(results),
    "results": results,
}
각각 살펴보겠습니다.
① query
"query": query어떤 검색어를 사용했는지 기록합니다.
나중에 여러 차례 검색한 결과를 분석할 때 어떤 검색어에서 나온 자료인지 알 수 있습니다.
② search_count
"search_count": search_count + 1현재 검색이 몇 번째 검색인지 기록합니다.
예를 들어 첫 번째 검색이라면 1, 두 번째 검색이라면 2가 됩니다.
③ total_results
"total_results": len(results)len()은 리스트나 문자열 등의 길이를 구하는 함수입니다.
예를 들어:
len(["A", "B", "C"])결과:
3따라서 검색 결과가 5개라면 total_results는 5가 됩니다.
④ results
"results": results실제 검색 결과 전체를 담습니다.
이 네 가지 정보를 합치면 다음과 같은 형태가 됩니다.
{
  "query": "한국 생성형 AI 시장 전망",
  "search_count": 1,
  "total_results": 2,
  "results": [
    {
      "title": "한국 AI 시장 전망",
      "url": "https://example.com/1",
      "content": "한국 AI 시장은...",
      "score": 0.95,
      "published_date": null
    },
    {
      "title": "생성형 AI 분석",
      "url": "https://example.com/2",
      "content": "생성형 AI는...",
      "score": 0.91,
      "published_date": null
    }
  ]
}
이제 다음 코드가 실행됩니다.
return json.dumps(
    result_data,
    ensure_ascii=False,
    indent=2,
)
여기서:
-
result_data: Python 딕셔너리
-
json.dumps(): 딕셔너리를 JSON 문자열로 변환
-
ensure_ascii=False: 한글을 그대로 표시
-
indent=2: 들여쓰기를 2칸으로 하여 읽기 쉽게 출력
최종적으로 JSON 문자열이 Research Agent에 반환됩니다.
12. 예외 처리
마지막 부분입니다.
except Exception as e:

    return json.dumps(
        {
            "error": "Tavily 검색 중 오류가 발생했습니다.",
            "detail": str(e),
        },
        ensure_ascii=False,
    )
try 블록에서 오류가 발생하면 except 블록이 실행됩니다.
① Exception
except Exception as e:Python에서 일반적인 예외를 처리하는 구문입니다.
예를 들어 다음과 같은 오류가 발생할 수 있습니다.
-
API Key가 잘못됨
-
인터넷 연결 실패
-
Tavily 서버 오류
-
응답 데이터 처리 오류
이런 예외를 e라는 변수에 담습니다.
② str(e)
"detail": str(e)예외 객체를 문자열로 변환합니다.
예를 들어 오류 내용이 다음과 같다면:
Unauthorized: Invalid API Key이 문자열을 결과에 포함합니다.
③ 왜 예외를 문자열로 반환할까요?
외부 API 호출이 실패했다고 해서 전체 에이전트 시스템이 반드시 중단될 필요는 없습니다.
도구가 오류 내용을 반환하면 Gemini가 그 내용을 읽고 다음 행동을 판단할 수 있습니다.
예를 들어:
{
  "error": "Tavily 검색 중 오류가 발생했습니다.",
  "detail": "Unauthorized: Invalid API Key"
}
이런 형태로 반환하면 Research Agent가 검색에 실패했다는 사실을 인식할 수 있습니다.
다만 이 방식은 오류를 정상적인 도구 응답으로 취급한다는 특징이 있습니다. 따라서 에이전트가 오류를 보고 재시도할 수도 있고, 실패를 무시하고 보고서를 작성할 수도 있습니다.
실제 운영환경에서는 오류를 로그로 기록하고, 재시도 가능한 오류와 재시도할 수 없는 오류를 구분하는 것이 더 좋습니다.
13. 세 파일을 연결한 실제 실행 과정
이제 지금까지 공부한 세 파일이 실제 Deep Research 시스템에서 어떻게 연결되는지 살펴보겠습니다.
사용자가 다음과 같이 요청했다고 가정하겠습니다.
2026년 한국 생성형 AI 시장의 규모와 주요 기업, 향후 5년간의 성장 전망을 조사해줘.
실행 과정을 단계별로 추적해 보겠습니다.
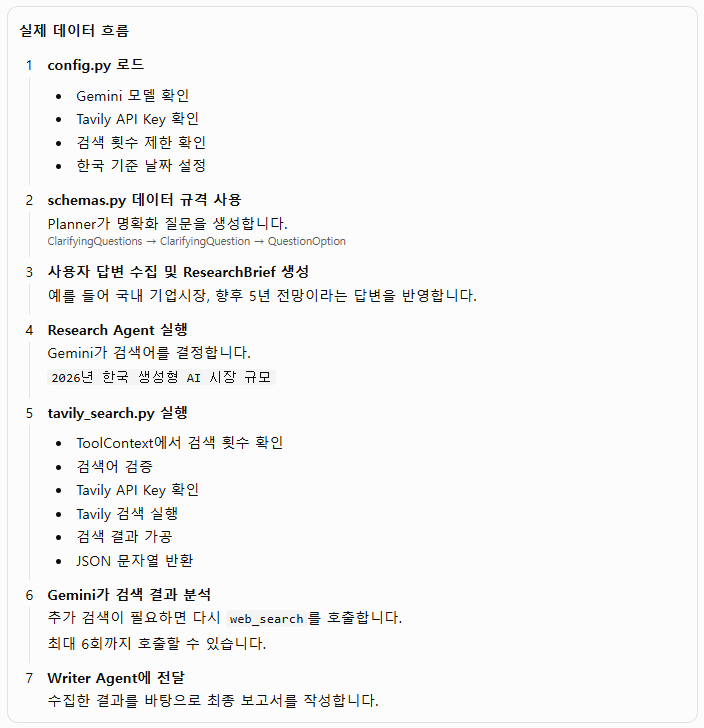
여기서 가장 중요한 개념은 다음과 같습니다.
-
config.py는 시스템의 설정을 제공합니다.
-
schemas.py는 에이전트 사이의 데이터 구조를 정의합니다.
-
tavily_search.py는 실제 외부 기능을 수행합니다.
이 세 가지가 서로 협력하여 하나의 AI Agent 시스템을 구성하는 것입니다.
14. 현재 코드에서 추가로 개선하면 좋은 사항
현재 잘 구동되고 있으므로 전체 구조를 바꿀 필요는 없습니다. 다만 실제 운영환경까지 고려한다면 다음 사항을 개선하는 것이 좋겠습니다.
| 항목 | 현재 코드 | 개선 의견 |
| API Key | os.getenv()로 재조회 | config의 상수 재사용 |
| 검색 횟수 | 호출 시도 전에 증가 | 현재 방식 유지 가능 |
| 검색 클라이언트 | 호출마다 생성 | 반복 검색 시 재사용 검토 |
| 오류 처리 | 모든 오류를 문자열 반환 | 오류 유형별 로깅 및 처리 |
| 검색 결과 | JSON 문자열 반환 | 현재 방식 유지 가능 |
| 검색 결과 검증 | 기본적인 필드 추출 | URL 및 내용 검증 추가 가능 |
특히 API Key 부분은 다음과 같이 바꾸는 것을 추천합니다.
기존:
import os

from ..config import MAX_SEARCH_CALLS, SEARCH_MAX_RESULTS

api_key = os.getenv("TAVILY_API_KEY")
개선:
from ..config import (
    TAVILY_API_KEY,
    MAX_SEARCH_CALLS,
    SEARCH_MAX_RESULTS,
)

api_key = TAVILY_API_KEY
이렇게 하면 설정을 config.py 한 곳에서 관리한다는 설계 원칙에 더 잘 맞습니다.
또한 현재 TavilyClient를 검색할 때마다 생성하는데, 검색을 많이 수행하는 환경에서는 클라이언트를 재사용하도록 개선할 수 있습니다. 다만 현재 규모에서는 반드시 변경해야 할 사항은 아닙니다.
한 가지 더 기억하실 점은 현재 검색 횟수 제한이 하나의 Invocation 내에서 작동한다는 것입니다. 여러 Invocation에 걸쳐 사용자별 일일 검색량을 제한하려면 별도의 세션 또는 사용자 단위 사용량 관리가 필요합니다.
15. 이번 학습에서 꼭 기억해야 할 핵심 용어
마지막으로 이번 세 파일에서 배운 개념을 정리하겠습니다.
| 개념 | 이해해야 할 내용 |
| load_dotenv() | .env 파일을 환경변수로 로드 |
| os.getenv() | 환경변수의 값을 가져옴 |
| Path | 파일 및 폴더 경로 관리 |
| ZoneInfo | 시간대 관리 |
| BaseModel | Pydantic 데이터 모델의 기본 클래스 |
| Field | 필드의 설명과 제약 조건 설정 |
| list[QuestionOption] | QuestionOption 객체들의 리스트 |
| default_factory=list | 객체마다 새로운 빈 리스트 생성 |
| model_dump() | Pydantic 객체를 딕셔너리로 변환 |
| json.dumps() | Python 객체를 JSON 문자열로 변환 |
| TavilyClient | Tavily API 호출 클라이언트 |
| ToolContext | ADK Tool 실행 컨텍스트 |
| tool_context.state | Tool에서 세션 상태에 접근 |
| temp: | 현재 Invocation의 임시 상태 |
| append() | 리스트에 데이터 추가 |
| strip() | 문자열 앞뒤 공백 제거 |
| try-except | 예외 처리 |
16. 이해도 확인을 위한 간단한 실습
이번 내용은 직접 코드를 조금 변경해 보면 훨씬 잘 이해됩니다.
다음 세 가지를 스스로 생각해 보시면 좋겠습니다.
3문제 미니 테스트
문제 1. MAX_SEARCH_CALLS를 6에서 10으로 변경하려면 어느 파일을 수정해야 할까요?
config.py에 공통 설정값이 정의되어 있으므로 이 파일만 수정하면 됩니다.
문제 2. ClarifyingQuestion의 options에 QuestionOption 객체를 사용하는 가장 큰 이유는 무엇일까요?
Pydantic을 통해 질문과 선택지의 구조 및 유효성을 관리하기 위해서입니다.
문제 3. 검색 횟수가 6회에 도달했을 때 실제 Tavily 검색을 막는 코드는 무엇일까요?
검색 횟수를 확인한 뒤 return으로 함수를 종료하기 때문에 Tavily API가 호출되지 않습니다.
이번 첫 번째 학습의 핵심은 세 파일의 역할을 확실하게 구분하는 것입니다.
특히 앞으로 ADK를 공부할 때는 schemas.py의 데이터 구조와 session.state의 상태 관리, 그리고 ToolContext를 통한 도구 실행 컨텍스트를 연결해서 이해하시면 좋습니다.
다음 두 번째 해설에서는 다음 세 파일을 다룹니다.
-
deep_research/prompts.py — 시스템 프롬프트와 LLM의 역할 지시
-
deep_research/agents/planner.py — 질문 생성과 Research Brief 생성
-
deep_research/agents/researcher.py 및 writer.py — 실제 에이전트 구성과 Tool 연결