이번 실습은 단순히 날씨를 알려주는 에이전트를 만든 것에서 한 단계 더 나아갔습니다. 에이전트가 어떤 도구를 선택하고, 도구를 실제로 실행하고, 그 결과를 바탕으로 답변하는지, 그리고 그 과정이 기대한 대로 작동했는지를 자동으로 평가하는 과정까지 완성한 것입니다.
나중에 다시 공부할 때 참고할 수 있도록 하나의 학습 노트 형태로 정리하겠습니다.
이번 설명은 다음 순서로 진행하겠습니다.
-
전체 프로젝트의 구조와 작동 원리
-
weather_agent.py 전체 코드 해설
-
__init__.py의 역할
-
seoul_daejeon_weather.test.json의 구조와 의미
-
ADK Eval의 평가 원리
-
실제 평가 결과를 읽는 방법
-
실행 및 재평가 방법
-
이번 실습에서 배워야 할 핵심 개념과 다음 단계
1. 전체 프로젝트 이해하기
1-1. 우리가 만든 것은 무엇인가?
이번 프로젝트의 이름은 weather_agent입니다.
사용자가 다음과 같이 질문한다고 가정하겠습니다.
서울과 대전 중 내일 어디가 더 따뜻해?
이 질문에 답하기 위해 에이전트는 다음 작업을 수행해야 합니다.
-
사용자가 내일 날씨를 물어봤다는 것을 이해합니다.
-
서울과 대전 두 도시를 비교해야 한다는 것을 이해합니다.
-
서울의 내일 날씨를 조회합니다.
-
대전의 내일 날씨를 조회합니다.
-
두 도시의 최고기온을 비교합니다.
-
비교 결과를 자연스러운 한국어 문장으로 답변합니다.
이것이 이번 에이전트의 핵심 기능입니다.
1-2. 전체 작동 구조
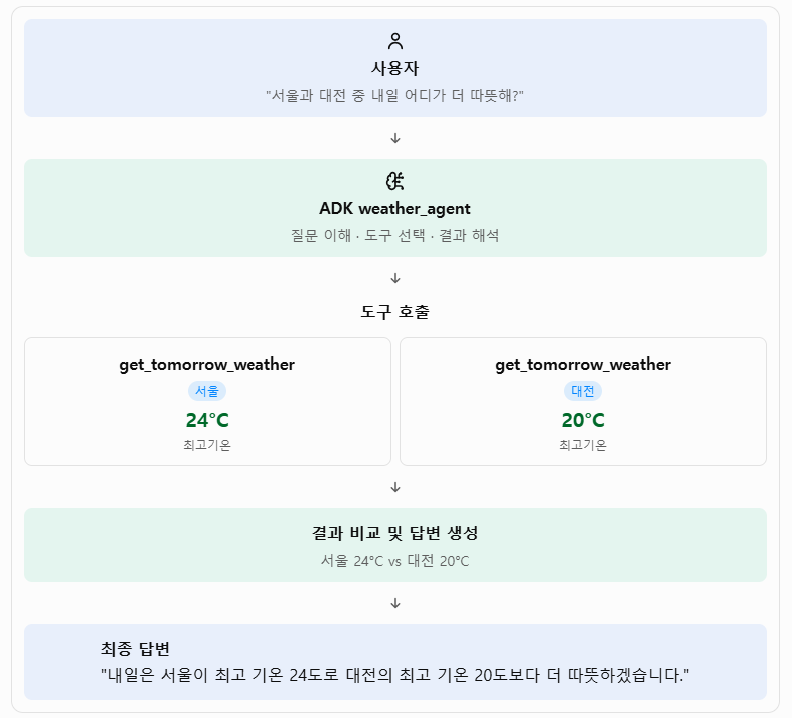
여기서 중요한 점은 에이전트와 Tool의 역할이 다르다는 것입니다.
| 구성 요소 | 역할 |
| LLM / Agent | 질문을 이해하고 어떤 Tool을 사용할지 결정 |
| Tool 함수 | 실제 날씨 데이터를 조회하여 반환 |
| Agent Instruction | Agent가 따라야 할 업무 규칙 |
| Mock Data | 이번 실습에서 사용할 가상의 날씨 데이터 |
| ADK Eval | Agent의 실행 결과가 기대한 결과와 일치하는지 평가 |
이번 구조에서 날씨 데이터를 가져오는 실제 작업은 Python 함수가 수행합니다. LLM이 날씨를 추측해서 답하는 구조가 아닙니다.
1-3. 프로젝트 폴더 구조
이번 실습의 폴더는 다음과 같이 이해하면 됩니다.
adk_/
│
├── weather_eval_agent/
│   ├── __init__.py
│   └── weather_agent.py
│
├── evals/
│   └── seoul_daejeon_weather.test.json
│
└── reports/
각 폴더와 파일의 역할은 다음과 같습니다.
| 파일·폴더 | 역할 |
| weather_eval_agent/ | 평가할 Agent 애플리케이션 |
| weather_agent.py | Agent와 Tool을 정의한 Python 코드 |
| __init__.py | ADK가 가져올 root_agent를 외부에 공개 |
| evals/ | 평가용 테스트 데이터 보관 |
| seoul_daejeon_weather.test.json | 사용자 질문, 기대 답변, 기대 Tool 호출 정의 |
| reports/ | 평가 결과를 보관하는 용도로 사용할 폴더 |
weather_eval_agent라는 별도 폴더를 만든 이유도 중요합니다.
기존에 실습했던 GCS Artifact 기반 Weather Agent와 이번 평가용 Agent를 분리하기 위해서입니다. 그래야 기존 프로젝트의 코드를 변경하지 않고, 독립적인 테스트를 수행할 수 있습니다.
2. weather_agent.py 코드 상세 해설
이제 Python 코드를 위에서부터 하나씩 살펴보겠습니다.
2-1. 라이브러리 가져오기
import osfrom typing import Dict, Unionfrom google.adk import Agent세 가지를 가져옵니다.
① os
os.getenv("GOOGLE_MODEL", "gemini-3.5-flash")이처럼 운영체제 환경변수에 접근할 때 사용합니다.
이번 코드에서는 사용할 Gemini 모델 이름을 환경변수에서 읽어옵니다.
② Dict, Union
Python 함수의 반환 데이터 형태를 명시하기 위한 타입 힌트입니다.
예를 들어 다음을 보겠습니다.
def get_tomorrow_weather(
    location: str
) -> Dict[str, Union[str, int]]:
이 함수는 다음과 같은 형태의 Dictionary를 반환한다는 의미입니다.
{
    "city": "서울",
    "weather": "Cloudy",
    "temperature": 21,
    "max_temp": 24
}-
Dict: Dictionary 자료형
-
str: 문자열
-
int: 정수
-
Union[str, int]: 문자열 또는 정수
따라서 Dict[str, Union[str, int]]는 키는 문자열이고, 값은 문자열 또는 정수인 Dictionary라는 의미입니다.
타입 힌트는 코드를 읽고 관리하기 쉽게 해줍니다. 이것만으로 실행 시 모든 데이터가 자동 검증되는 것은 아닙니다.
③ Agent
from google.adk import AgentGoogle ADK에서 Agent 객체를 만들기 위해 가져옵니다.
이 클래스가 이번 프로젝트의 중심입니다.
2-2. 목업 데이터 정의
여기서부터 실제 날씨 데이터를 준비합니다.
목업(Mock)은 실제 외부 서비스에서 가져온 데이터가 아니라, 테스트를 위해 미리 만들어 놓은 가상 데이터입니다.
현재 날씨 데이터
MOCK_WEATHER_DATA = {
    "seoul": {
        "city": "서울",
        "condition": "Clear",
        "temperature_c": 22,
        "min_temp_c": 12,
        "max_temp_c": 22,
        "humidity": 45,
        "summary": "서울은 맑고 쾌청합니다.",
    },
    "daejeon": {
        "city": "대전",
        "condition": "Cloudy",
        "temperature_c": 20,
        "min_temp_c": 10,
        "max_temp_c": 18,
        "humidity": 60,
        "summary": "대전은 흐리고 바람이 약간 붑니다.",
    },
}
두 도시의 현재 날씨 정보를 Dictionary 형태로 저장했습니다.
데이터 구조를 그림으로 표현하면 다음과 같습니다.
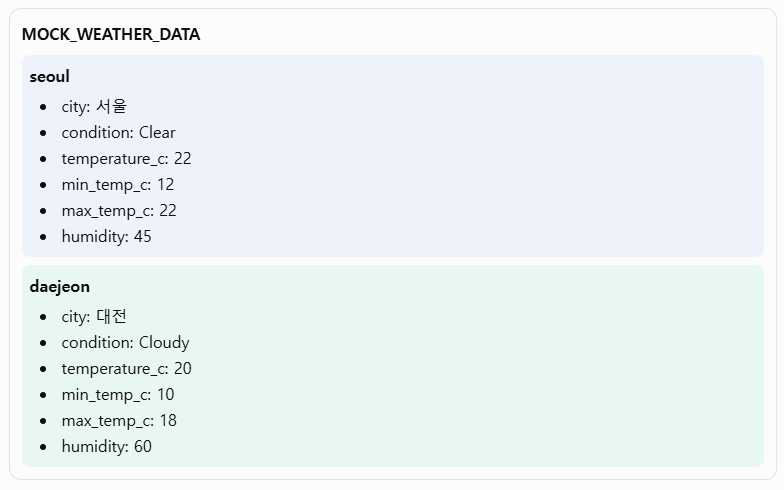
여기서 주의할 것은 Dictionary의 구조입니다.
MOCK_WEATHER_DATA["seoul"]["max_temp_c"]이렇게 접근하면 서울의 최고기온인 22를 가져옵니다.
두 단계로 접근하는 것입니다.
-
MOCK_WEATHER_DATA["seoul"] → 서울 데이터 전체
-
["max_temp_c"] → 그 데이터 안의 최고기온
내일 날씨 데이터
MOCK_TOMORROW_WEATHER_DATA = {
    "seoul": {
        "city": "서울",
        "condition": "Cloudy",
        "temperature_c": 21,
        "min_temp_c": 13,
        "max_temp_c": 24,
        "humidity": 50,
        "summary": "내일 서울은 구름이 많지만 야외 활동은 가능합니다.",
    },
    "daejeon": {
        "city": "대전",
        "condition": "Rain",
        "temperature_c": 18,
        "min_temp_c": 12,
        "max_temp_c": 20,
        "humidity": 75,
        "summary": "내일 대전은 비가 예상됩니다.",
    },
}
현재 날씨 데이터와 별도로 내일 날씨 데이터를 준비했습니다.
두 데이터의 차이를 보면 다음과 같습니다.
| 항목 | 서울 현재 | 서울 내일 | 대전 현재 | 대전 내일 |
| 기온 | 22°C | 21°C | 20°C | 18°C |
| 최저기온 | 12°C | 13°C | 10°C | 12°C |
| 최고기온 | 22°C | 24°C | 18°C | 20°C |
| 습도 | 45% | 50% | 60% | 75% |
| 상태 | 맑음 | 구름 많음 | 흐림 | 비 |
이렇게 현재와 내일의 데이터를 분리한 이유는 Agent가 질문의 시간 표현을 이해하고 적절한 Tool을 선택하도록 하기 위해서입니다.
예를 들어:
-
"서울 현재 날씨는?" → MOCK_WEATHER_DATA
-
"서울 내일 날씨는?" → MOCK_TOMORROW_WEATHER_DATA
실제 서비스라면 이 부분이 기상청 API나 Open-Meteo 같은 외부 데이터 소스로 바뀔 수 있습니다.
2-3. 도시명 별칭 정의
CITY_ALIASES = {
    "서울": "seoul",
    "seoul": "seoul",
    "대전": "daejeon",
    "daejeon": "daejeon",
}
사용자가 도시명을 한국어로 입력할 수도 있고 영어로 입력할 수도 있습니다.
그런데 내부 데이터의 키는 모두 소문자 영어입니다.
예를 들어:
MOCK_TOMORROW_WEATHER_DATA["seoul"]이렇게 접근해야 합니다.
따라서 입력된 도시명을 내부에서 사용하는 키로 바꾸는 과정이 필요합니다.
| 서울 | seoul |
| Seoul | seoul |
| 대전 | daejeon |
| Daejeon | daejeon |
이 작업을 정규화(Normalization)라고 합니다.
이 개념은 Agent 개발에서 매우 중요합니다.
사용자가 다양한 형태로 질문하더라도 내부 시스템에서는 일관된 형태로 처리할 수 있기 때문입니다.
2-4. normalize_location() 함수
def normalize_location(location: str) -> str | None:
    """도시명을 내부키(seoul, daejeon)로 정규화합니다."""

    lowered = location.strip().lower()

    for alias, key in CITY_ALIASES.items():
        if alias in lowered:
            return key

    return None
이 함수는 사용자 입력을 내부 데이터에서 사용할 수 있는 도시 키로 변환합니다.
한 줄씩 보겠습니다.
① 함수 선언
def normalize_location(location: str) -> str | None:-
함수 이름: normalize_location
-
입력값: location
-
입력 타입: 문자열
-
반환 타입: 문자열 또는 None
여기서 str | None은 Python 3.10부터 사용할 수 있는 타입 표기입니다.
② 공백 제거 및 소문자 변환
lowered = location.strip().lower()두 가지 작업을 합니다.
-
strip() : 앞뒤 공백 제거
-
lower() : 영어 대문자를 소문자로 변환
예를 들어:
" Seoul ".strip().lower()결과는 다음과 같습니다.
"seoul"③ 별칭을 하나씩 확인
for alias, key in CITY_ALIASES.items():Dictionary에 등록된 항목을 하나씩 순회합니다.
예를 들어 첫 번째 반복에서는:
alias = "서울"
key = "seoul"
다음 반복에서는:
alias = "seoul"
key = "seoul"
이런 방식으로 진행됩니다.
④ 입력 문자열에 별칭이 있는지 확인
if alias in lowered:
	return key
입력값 안에 별칭이 포함되어 있으면 내부 키를 반환합니다.
예를 들어:
normalize_location("서울 날씨 알려줘")결과는:
"seoul"입니다.
⑤ 지원하지 않는 도시
return None등록된 별칭이 하나도 없으면 None을 반환합니다.
예를 들어:
normalize_location("부산")결과는:
None입니다.
여기서 한 가지 보충하겠습니다. 현재 코드는 in으로 문자열 포함 여부를 확인하기 때문에 "서울 날씨"처럼 문장 안에 도시명이 들어 있어도 작동합니다. 다만 "notseoul"처럼 의도하지 않은 문자열에도 일치할 수 있습니다. 실제 서비스에서는 도시명 추출이나 정확한 별칭 매칭을 더 엄격하게 구현하는 것이 좋습니다.
2-5. validate_location() 함수
def validate_location(location: str) -> bool:
    """(Helper) 지역명이 지원 가능한 범위인지 확인합니다."""

    return normalize_location(location) is not None
이 함수는 입력한 도시가 지원 가능한 도시인지 확인합니다.
앞에서 만든 normalize_location()을 재사용합니다.
예를 들어:
validate_location("서울")결과:
True반면:
validate_location("부산")결과:
False여기서 is not None은 정규화 결과가 None이 아닌지를 검사한다는 뜻입니다.
다만 현재 코드에서는 validate_location()을 별도로 호출하지 않습니다.
실제 검증은 뒤에서 설명할 두 날씨 Tool 내부에서 normalize_location()을 직접 호출하는 방식으로 이루어집니다.
즉, 이 함수는 향후 다른 기능에서 재사용할 수 있도록 만들어 둔 보조 함수입니다.
2-6. get_current_weather() 함수
이제 첫 번째 실제 Tool입니다.
def get_current_weather(
    location: str
) -> Dict[str, Union[str, int]]:
이 함수는 특정 도시의 현재 날씨를 조회합니다.
여기서 가장 중요한 개념은 일반 Python 함수가 ADK Agent의 Tool로 사용될 수 있다는 것입니다.
Agent가 이 함수를 호출하면 Python 코드가 실행되고, 반환된 결과가 다시 Agent에게 전달됩니다.
① 함수 설명(Docstring)
"""지정된 도시의 '현재' 날씨 정보를 조회합니다.

사용자가 현재 시점의 날씨를 물어볼 때 이 도구를 사용하세요.
서울(Seoul)과 대전(Daejeon) 지역만 지원합니다.
...
"""
이 부분은 함수의 설명입니다.
ADK가 함수를 Tool로 사용할 때 함수 이름, 설명, 인자 등을 바탕으로 모델이 도구의 용도를 이해하는 데 도움을 줍니다.
특히 다음 문장이 중요합니다.
사용자가 현재 시점의 날씨를 물어볼 때 이 도구를 사용하세요.
이것은 Agent에게 이 Tool의 용도를 알려주는 역할을 합니다.
② 실행 로그
print(f"[System] get_current_weather 호출: {location}")함수가 실제로 호출됐는지 확인하기 위한 로그입니다.
예를 들어 사용자가 서울의 현재 날씨를 질문하면:
[System] get_current_weather 호출: 서울이런 형태로 출력됩니다.
디버깅할 때 매우 유용합니다.
③ 도시명 정규화
city_key = normalize_location(location)입력받은 도시명을 내부 키로 변환합니다.
예를 들어:
location = "서울"이라면:
city_key = "seoul"이 됩니다.
④ 지원 여부 확인
if city_key is None:
    return {
        "error": "Unsupported Location",
        "message": "현재 서울과 대전 지역만 지원합니다."
    }
지원하지 않는 지역이라면 오류 정보를 반환합니다.
여기서 중요한 것은 함수가 프로그램을 강제로 종료하는 것이 아니라, 오류 정보를 Dictionary 형태로 반환한다는 점입니다.
Agent는 이 반환 결과를 보고 사용자에게 지원하지 않는 지역이라고 안내할 수 있습니다.
⑤ 실제 데이터 조회
data = MOCK_WEATHER_DATA[city_key]내부 Dictionary에서 해당 도시의 현재 날씨를 가져옵니다.
서울이라면 다음 데이터가 선택됩니다.
MOCK_WEATHER_DATA["seoul"]⑥ 결과 반환
return {
    "city": data["city"],
    "weather": data["condition"],
    "temperature": data["temperature_c"],
    "min_temp": data["min_temp_c"],
    "max_temp": data["max_temp_c"],
    "humidity": data["humidity"],
    "description": data["summary"],
}
여기서 중요한 부분은 원본 데이터의 필드명을 Tool의 반환 데이터에 맞게 바꾸고 있다는 점입니다.
| 원본 데이터 필드 | Tool 반환 필드 |
| city | city |
| condition | weather |
| temperature_c | temperature |
| min_temp_c | min_temp |
| max_temp_c | max_temp |
| humidity | humidity |
| summary | description |
왜 이렇게 했을까요?
원본 데이터 구조와 Agent가 사용하기 편한 결과 구조를 분리한 것입니다.
원본 데이터의 내부 필드명을 바꾸더라도 Tool의 반환 형식을 유지할 수 있습니다.
2-7. get_tomorrow_weather() 함수
두 번째 Tool입니다.
def get_tomorrow_weather(
    location: str
) -> Dict[str, Union[str, int]]:
현재 날씨 Tool과 구조가 거의 같습니다.
차이는 조회하는 데이터가 다음과 같다는 것입니다.
data = MOCK_TOMORROW_WEATHER_DATA[city_key]즉, 내일 날씨 데이터를 조회합니다.
실행 로그도 별도로 출력합니다.
print(f"[System] get_tomorrow_weather 호출:{location}")그리고 최종 반환값은 다음과 같습니다.
return {
    "city": data["city"],
    "weather": data["condition"],
    "temperature": data["temperature_c"],
    "min_temp": data["min_temp_c"],
    "max_temp": data["max_temp_c"],
    "humidity": data["humidity"],
    "description": data["summary"],
}
여기서 이번 평가와 직접적으로 관련된 필드는 다음입니다.
"max_temp": data["max_temp_c"]서울의 경우:
"max_temp": 24대전의 경우:
"max_temp": 20이 값이 있어야 Agent가 두 도시의 최고기온을 비교할 수 있습니다.
이번 실습에서 특히 중요했던 오류
이전에 평가가 제대로 되지 않았던 과정에서 두 가지 문제를 확인했습니다.
-
temperature 필드의 오타
-
max_temp 필드의 누락
이번에는 이 부분을 바로잡아 정상적인 데이터가 반환되도록 했습니다.
이 사례에서 기억할 점은 다음입니다.
Tool이 정상적으로 호출되는 것과 Tool이 올바른 데이터를 반환하는 것은 서로 다른 문제입니다.
Tool 호출에 성공하더라도 필요한 데이터 필드가 빠져 있으면 Agent가 정확한 답변을 만들 수 없습니다.
3. Agent 객체 생성 및 설정
이제 앞에서 만든 함수들을 실제 Agent에 연결합니다.
이 부분이 이번 Python 코드의 핵심입니다.
weather_agent = Agent(
    model = os.getenv("GOOGLE_MODEL", "gemini-3.5-flash"),
    name="weather_agent",
    description="날씨를 알려주는 에이전트입니다.",
    instruction=""" ... """,
    tools = [get_current_weather, get_tomorrow_weather],
)

root_agent = weather_agent
하나씩 살펴보겠습니다.
3-1. model: 어떤 LLM을 사용할 것인가?
model = os.getenv("GOOGLE_MODEL", "gemini-3.5-flash")Agent의 두뇌 역할을 할 LLM을 지정합니다.
여기서 os.getenv()는 환경변수를 읽는 함수입니다.
사용법은 다음과 같습니다.
os.getenv("환경변수 이름", "기본값")따라서 현재 코드는 다음과 같은 의미입니다.
-
GOOGLE_MODEL이라는 환경변수가 설정되어 있으면 그 값을 사용합니다.
-
설정되어 있지 않으면 gemini-3.5-flash를 사용합니다.
예를 들어 PowerShell에서 다음과 같이 환경변수를 지정할 수 있습니다.
$env:GOOGLE_MODEL = "gemini-3.5-flash"그러면 Agent는 해당 모델을 사용합니다.
이 방식을 사용하면 Python 코드를 수정하지 않고도 모델을 변경할 수 있습니다.
참고로 앞서 확인한 평가 결과에는 실제 실행 모델이 gemini-3.6-flash로 기록된 결과도 있었습니다. 이는 해당 실행 당시 환경변수에 다른 모델이 설정되어 있었을 가능성이 있습니다. 따라서 실제 사용 모델은 코드의 기본값만 보지 말고 실행 환경과 평가 로그를 함께 확인해야 합니다.
3-2. name: Agent의 내부 이름
name="weather_agent"Agent의 이름입니다.
이 이름은 ADK가 Agent를 식별하는 데 사용됩니다.
이번 테스트 JSON에도 다음과 같이 설정되어 있습니다.
"session_input": {
    "app_name": "weather_agent"
}
두 이름을 일치시킨 것이 중요합니다.
이번 실습에서는 다음과 같이 맞춰져 있습니다.
| 위치 | 이름 |
| Agent 객체 | weather_agent |
| ADK 앱 이름 | weather_agent |
| 테스트 JSON의 app_name | weather_agent |
이름이 서로 맞지 않으면 애플리케이션 로딩이나 평가 과정에서 문제가 생길 수 있습니다.
3-3. description: Agent의 설명
description="날씨를 알려주는 에이전트입니다."Agent가 어떤 일을 하는지 설명합니다.
여러 Agent가 협력하는 멀티에이전트 환경에서는 이 설명이 특히 중요합니다.
예를 들어 Manager Agent가 여러 하위 Agent 중 하나를 선택해야 한다고 가정하겠습니다.
-
Weather Agent: 날씨 조회
-
Research Agent: 자료 조사
-
Document Agent: 문서 작성
이때 description은 각 Agent의 역할을 구분하는 데 도움이 됩니다.
3-4. instruction: Agent의 업무 지침
이번 실습에서 가장 중요한 부분 중 하나입니다.
instruction="""당신은 서울과 대전의 날씨를 알려주는 날씨 에이전트입니다.

1. 사용자가 현재 날씨를 질문하면
   반드시 get_current_weather 도구를 호출합니다.

2. 사용자가 내일 날씨를 질문하면
   반드시 get_tomorrow_weather 도구를 호출합니다.

3. 두 도시를 비교하는 질문이면
   각 도시에 대해 get_tomorrow_weather 도구를
   각각 호출해야 합니다.

4. 기온 비교 질문에서는 max_temp 값을 기준으로
   최고기온을 비교합니다.

5. 도구에서 반환된 데이터만 사용하여 답변합니다.
   임의로 날씨 정보를 만들어내지 않습니다.

6. 두 도시의 내일 최고기온 비교 질문에는
   다음 형식으로 한 문장으로만 답변합니다.

   "내일은 서울이 최고 기온 24도로 대전의
   최고 기온 20도보다 더 따뜻하겠습니다."

   단, 위 문장의 도시명과 기온은 반드시
   실제 도구 반환값으로 대체합니다.

7. 비교 결과만 간결하게 답변합니다.
   불필요한 제목, Markdown, 목록, 부가 설명은
   추가하지 않습니다."""
Instruction은 Agent에게 주는 업무 지침입니다.
이번 지침은 크게 세 가지 영역으로 나눌 수 있습니다.
| 구분 | 지침 | 목적 |
| Tool 선택 | 현재/내일에 따라 Tool 선택 | 올바른 도구 호출 |
| 업무 수행 | 두 도시 각각 조회, 최고기온 비교 | 올바른 데이터 처리 |
| 답변 생성 | 한 문장, 정해진 형식 | 기대한 결과 생성 |
① 현재 날씨와 내일 날씨 구분
사용자가 현재 날씨를 질문하면
반드시 get_current_weather 도구를 호출합니다.
이 지침은 Agent에게 Tool 선택 기준을 알려줍니다.
예를 들어 다음 질문이 들어오면:
서울 현재 날씨 알려줘.
Agent는 get_current_weather를 선택해야 합니다.
반면:
서울 내일 날씨 알려줘.
이 질문에는 get_tomorrow_weather를 선택해야 합니다.
② 두 도시를 비교할 때 각각 호출
두 도시를 비교하는 질문이면
각 도시에 대해 get_tomorrow_weather 도구를
각각 호출해야 합니다.
이 지침이 이번 평가의 핵심입니다.
사용자가 두 도시를 비교하라고 했기 때문에 Tool을 두 번 호출해야 합니다.
첫 번째 호출:
get_tomorrow_weather("Seoul")두 번째 호출:
get_tomorrow_weather("Daejeon")여기서 주목할 점은 Agent가 하나의 질문에 대해 여러 번 Tool을 호출할 수 있다는 사실입니다.
이번 실습은 하나의 사용자 질문에서 두 번의 Tool 호출을 수행하는 사례입니다.
③ 최고기온 기준으로 비교
기온 비교 질문에서는 max_temp 값을 기준으로
최고기온을 비교합니다.
날씨 데이터에는 여러 기온이 있습니다.
-
현재 기온
-
최저기온
-
최고기온
그런데 사용자가 "어디가 더 따뜻해?"라고 질문했을 때 이번 실습에서는 최고기온을 기준으로 비교하기로 했습니다.
따라서:
서울 max_temp = 24
대전 max_temp = 20
두 값을 비교해서 서울이 더 따뜻하다고 판단해야 합니다.
④ 도구 데이터만 사용
도구에서 반환된 데이터만 사용하여 답변합니다.
임의로 날씨 정보를 만들어내지 않습니다.
이 부분은 Agent 개발에서 매우 중요한 원칙입니다.
LLM은 언어를 생성하는 모델이기 때문에 그럴듯한 답변을 만들 수 있습니다.
하지만 실제 데이터가 필요한 업무에서는 그럴듯한 답변보다 정확한 데이터가 중요합니다.
따라서 다음과 같이 역할을 나누는 것이 좋습니다.
-
Tool: 실제 데이터 조회
-
Agent: 조회 결과 해석 및 설명
이것이 Tool을 사용하는 Agent를 만드는 중요한 이유입니다.
⑤ 답변 형식을 제한한 이유
두 도시의 내일 최고기온 비교 질문에는
다음 형식으로 한 문장으로만 답변합니다.
이 지침을 추가한 이유는 이번 평가 과정에서 확인했습니다.
처음에는 Agent가 다음과 같이 답변했습니다.
내일 최고기온(max_temp) 기준으로
서울이 대전보다 더 따뜻합니다.

서울: 최고기온 24°C (최저 13°C, 구름 많음)
대전: 최고기온 20°C (최저 12°C, 비 예상)
사람이 읽기에는 충분히 정확한 답변입니다.
그런데 평가 데이터가 기대하는 문장은 다음과 같았습니다.
내일은 서울이 최고 기온 24도로
대전의 최고 기온 20도보다 더 따뜻하겠습니다.
내용은 사실상 동일하지만 표현과 길이가 달랐습니다.
그 결과 response_match_score가 기준에 미달했습니다.
그래서 Instruction에 답변 형식까지 구체적으로 지정한 것입니다.
여기서 한 가지 주의할 점이 있습니다.
현재 Instruction의 예시에는 서울, 24도, 대전, 20도라는 구체적인 값이 들어 있습니다. 실제 데이터가 바뀌었을 때도 이 값이 그대로 사용되면 안 됩니다.
실제 서비스에서는 다음과 같은 원칙을 지시하는 것이 더 안전합니다.
비교 결과는 실제 Tool 반환값을 사용하여
다음 문장 구조로 답변합니다.

"내일은 [최고기온이 높은 도시]가 최고 기온
[해당 도시의 최고기온]도로
[다른 도시]의 최고 기온
[다른 도시의 최고기온]도보다
더 따뜻하겠습니다."

대괄호 안의 값은 반드시 Tool 반환값으로 채웁니다.
이렇게 하면 데이터가 바뀌어도 문장 구조를 유지할 수 있습니다.
다만 자연어 지시만으로 모든 상황에서 수치가 정확히 들어간다고 보장할 수는 없습니다. 실제 업무에서 정확성이 중요하다면 Python 함수에서 비교와 문장 조립까지 수행하는 방식도 고려할 수 있습니다.
3-5. tools: Agent가 사용할 수 있는 도구 등록
tools = [
    get_current_weather,
    get_tomorrow_weather
]
이 부분은 Agent에게 사용할 수 있는 Tool을 등록하는 과정입니다.
우리는 앞에서 두 개의 Python 함수를 만들었습니다.
-
get_current_weather
-
get_tomorrow_weather
이 함수들을 tools 목록에 넣으면 Agent가 필요에 따라 호출할 수 있습니다.
여기서 기억해야 할 점은 다음과 같습니다.
Python 함수를 정의하는 것과 Agent에 Tool로 등록하는 것은 별개의 작업입니다.
함수를 정의했다고 자동으로 Agent가 사용할 수 있는 것은 아닙니다.
Agent의 tools 목록에 등록해야 합니다.
3-6. root_agent: ADK가 찾는 진입점
root_agent = weather_agent이 한 줄도 매우 중요합니다.
ADK는 Agent 프로젝트를 로딩할 때 일반적으로 root_agent라는 이름의 객체를 진입점으로 찾습니다.
우리가 만든 Agent 객체의 이름은 weather_agent입니다.
따라서:
root_agent = weather_agent라고 지정해서 ADK가 이 객체를 사용할 수 있도록 합니다.
비유하면 다음과 같습니다.
-
weather_agent: 실제로 만들어 놓은 자동차
-
root_agent: ADK에게 이 자동차를 사용하라고 알려주는 출입구
이 부분이 없거나 잘못 지정되면 ADK가 실행할 Agent를 찾지 못할 수 있습니다.
4. init.py 파일 해설
사용자가 작성한 코드는 다음과 같습니다.
from .weather_agent import root_agent짧지만 Python 패키지 구조에서 중요한 역할을 합니다.
4-1. __init__.py란?
Python에서 폴더를 패키지로 인식시키고, 패키지가 가져올 기본 구성요소를 정의할 때 사용하는 파일입니다.
이번 프로젝트에서:
weather_eval_agent/
    ├── __init__.py
    └── weather_agent.py
이렇게 구성했습니다.
__init__.py는 다음을 의미합니다.
from .weather_agent import root_agent-
. : 현재 패키지 폴더
-
weather_agent : 같은 폴더에 있는 Python 모듈
-
import root_agent : 해당 모듈에서 root_agent 객체를 가져옴
즉, ADK가 weather_eval_agent 폴더를 로딩할 때 root_agent를 쉽게 찾을 수 있도록 해줍니다.
4-2. 왜 필요한가?
이번 프로젝트의 Agent를 ADK에서 실행하거나 평가할 때 ADK가 Agent 객체를 찾아야 합니다.
그때 __init__.py에서 root_agent를 공개해 두면 패키지 진입점을 명확하게 만들 수 있습니다.
이번 실습에서는 다음 두 가지를 기억하면 됩니다.
-
weather_agent.py에서 실제 Agent를 생성한다.
-
__init__.py에서 root_agent를 외부에 공개한다.
5. seoul_daejeon_weather.test.json 해설
이제 평가 데이터 파일을 살펴보겠습니다.
이 파일은 이번 실습의 두 번째 핵심 파일입니다.
weather_agent.py가 실제 Agent를 만드는 파일이라면, JSON 파일은 그 Agent가 어떻게 행동해야 하는지를 정의하는 시험 문제와 정답지라고 이해하면 됩니다.
5-1. 전체 구조
{
    "eval_set_id": "...",
    "name": "...",
    "description": "...",
    "eval_cases": [
        {
            "eval_id": "...",
            "conversation": [
                {
                    "invocation_id": "...",
                    "user_content": {},
                    "final_response": {},
                    "intermediate_data": {}
                }
            ],
            "session_input": {}
        }
    ]
}
크게 네 부분으로 구성되어 있습니다.
| 구성 | 의미 |
| eval_set_id | 평가 세트의 고유 ID |
| name | 평가 세트 이름 |
| description | 평가 목적 |
| eval_cases | 실제 평가 사례 목록 |
이번에는 평가 사례가 하나뿐이지만, 여러 사례를 넣을 수도 있습니다.
예를 들어 다음과 같이 확장할 수 있습니다.
-
서울 현재 날씨 조회
-
대전 현재 날씨 조회
-
서울 내일 날씨 조회
-
서울과 대전 내일 최고기온 비교
-
지원하지 않는 부산 날씨 요청
이렇게 여러 가지 상황을 테스트하는 것이 좋습니다.
5-2. eval_set_id
"eval_set_id": "weather_compare_seoul_daejeon_set"평가 세트의 식별자입니다.
이번 테스트의 이름을 나타냅니다.
5-3. name과 description
"name": "Weather Compare: Seoul vs Daejeon (Tomorrow)",
"description": "내일 서울과 대전의 기온을 비교하는 시나리오에 대한 유닛 테스트"
사람이 평가 내용을 이해하기 위한 정보입니다.
-
name: 평가 시나리오의 제목
-
description: 어떤 상황을 테스트하는지 설명
5-4. eval_cases
"eval_cases": [
    {
        "eval_id": "compare_case_01",
        ...
    }
]
실제 평가할 사례를 담는 배열입니다.
JSON에서 []는 배열을 의미합니다.
따라서 eval_cases 안에는 여러 개의 평가 사례를 넣을 수 있습니다.
이번에는 compare_case_01이라는 사례 하나를 만들었습니다.
5-5. conversation
"conversation": [
    {
        ...
    }
]
사용자와 Agent가 주고받는 대화 내용을 정의합니다.
이번에는 대화가 한 번의 질문과 답변으로 구성됩니다.
① invocation_id
"invocation_id": "test-invoke-001"하나의 Agent 실행 단위를 식별하는 ID입니다.
이번 테스트에서 해당 질문과 응답을 구분하기 위한 식별자로 사용됩니다.
② user_content
"user_content": {
    "role": "user",
    "parts": [
        {
            "text": "서울과 대전중 내일 어디가 더 따뜻해?"
        }
    ]
}
사용자가 실제로 입력한 질문입니다.
여기서 중요한 것은 role입니다.
"role": "user"질문을 입력한 주체가 사용자라는 뜻입니다.
그리고 parts 안에 실제 텍스트가 들어갑니다.
이번 평가에서 Agent에게 전달되는 질문은 다음입니다.
서울과 대전중 내일 어디가 더 따뜻해?
③ final_response
"final_response": {
    "role": "model",
    "parts": [
        {
            "text": "내일은 서울이 최고 기온 24도로 대전의 최고 기온 20도보다 더 따뜻하겠습니다."
        }
    ]
}
이 부분이 중요합니다.
이것은 Agent가 최종적으로 만들어야 하는 기대 답변입니다.
즉, 평가기는 실제 Agent의 최종 답변을 이 내용과 비교합니다.
여기서 role은 model입니다.
사용자가 작성한 문장이 아니라 모델이 생성해야 할 답변이기 때문입니다.
이번 실습에서는 답변의 의미뿐 아니라 표현과 형식까지 일치하도록 기대 답변을 명확하게 작성했습니다.
5-6. intermediate_data: Tool 호출 기대값
이번 JSON에서 특히 중요한 부분입니다.
"intermediate_data": {
    "tool_uses": [
        {
            "name": "get_tomorrow_weather",
            "args": {
                "location": "Seoul"
            }
        },
        {
            "name": "get_tomorrow_weather",
            "args": {
                "location": "Daejeon"
            }
        }
    ],
    "intermediate_responses": []
}
이것은 최종 답변만 평가하는 것이 아니라, 그 답변을 만들기 위해 Agent가 어떤 Tool을 호출해야 하는지도 평가한다는 의미입니다.
기대하는 Tool 호출은 두 번입니다.
첫 번째:
{
    "name": "get_tomorrow_weather",
    "args": {
        "location": "Seoul"
    }
}
두 번째:
{
    "name": "get_tomorrow_weather",
    "args": {
        "location": "Daejeon"
    }
}
즉, 다음을 모두 확인합니다.
-
올바른 Tool을 호출했는가?
-
서울을 조회했는가?
-
대전을 조회했는가?
-
두 번 호출했는가?
-
호출 인자가 기대한 값과 일치하는가?
이것이 ADK Eval의 중요한 기능 중 하나입니다.
intermediate_responses는 무엇인가?
"intermediate_responses": []중간 응답을 별도로 정의하지 않았다는 의미입니다.
이번 평가에서는 중간에 사용자에게 보여줄 별도 메시지를 평가 대상으로 설정하지 않았습니다.
5-7. session_input
"session_input": {
    "app_name": "weather_agent",
    "user_id": "test_user",
    "state": {}
}
Agent를 실행할 세션 환경을 정의합니다.
각 항목을 살펴보겠습니다.
| 필드 | 의미 |
| app_name | 실행할 ADK 애플리케이션 이름 |
| user_id | 테스트 사용자 식별자 |
| state | 세션 시작 시 제공할 상태 데이터 |
여기서 특히 중요한 것은 app_name입니다.
"app_name": "weather_agent"앞에서 만든 Agent의 이름 및 애플리케이션 이름과 일치해야 합니다.
user_id는 테스트용 사용자 ID입니다.
실제 서비스에서 로그인한 사용자 ID와 같은 개념으로 이해할 수 있지만, 이번 테스트에서는 단순한 테스트 식별자입니다.
state는 초기 상태값입니다.
이번에는 별도로 기억하거나 전달할 상태 데이터가 없으므로 빈 Dictionary로 설정했습니다.
6. ADK Eval은 어떻게 평가하는가?
이제 이번 실습의 가장 중요한 학습 내용인 평가(Evaluation)를 살펴보겠습니다.
개인적으로 이번 실습에서 가장 중요한 부분이라고 생각합니다.
왜냐하면 지금까지는 Agent를 만들고 실행해서 답변이 잘 나오는지를 확인하는 데 집중했다면, 이제부터는 Agent가 올바르게 작동했는지를 객관적인 기준으로 측정하는 방법을 배우기 때문입니다.
6-1. 일반적인 실행 테스트와 ADK Eval의 차이
일반적인 실행 테스트는 다음과 같습니다.
-
Agent를 실행합니다.
-
질문을 입력합니다.
-
답변이 나오는지 확인합니다.
-
사람이 읽어보고 맞는지 판단합니다.
이 방법은 간단하지만 몇 가지 한계가 있습니다.
-
답변이 맞는 것처럼 보여도 잘못된 Tool을 호출했을 수 있습니다.
-
Tool을 호출하지 않고 LLM이 알고 있는 내용으로 답했을 수도 있습니다.
-
여러 번 테스트할 때마다 사람이 일일이 확인해야 합니다.
-
코드가 변경된 후 기존 기능이 깨졌는지 확인하기 어렵습니다.
ADK Eval은 이런 문제를 해결하기 위한 자동 평가 기능입니다.
이번 실습에서는 두 가지 핵심 항목을 평가했습니다.
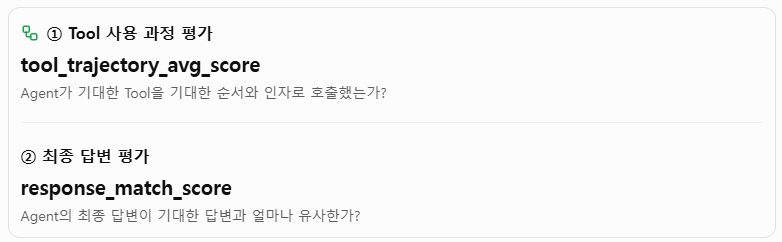
이 두 가지를 구분해서 이해하는 것이 중요합니다.
① Tool 평가 = 일을 수행하는 과정이 올바른가?
② 답변 평가 = 최종 결과가 기대한 내용과 일치하는가?
6-2. tool_trajectory_avg_score 상세 해설
이 지표는 Agent가 실제로 호출한 Tool의 실행 경로(Trajectory)를 기대한 실행 경로와 비교합니다.
이번 JSON에서 기대하는 Tool 호출은 다음과 같습니다.
"tool_uses": [
    {
        "name": "get_tomorrow_weather",
        "args": {
            "location": "Seoul"
        }
    },
    {
        "name": "get_tomorrow_weather",
        "args": {
            "location": "Daejeon"
        }
    }
]
평가기가 기대하는 실행 경로는 다음과 같습니다.
사용자 질문
    |
    v
get_tomorrow_weather("Seoul")
    |
    v
get_tomorrow_weather("Daejeon")
    |
    v
최종 답변
그런데 실제 Agent가 다음처럼 실행했다면 어떻게 될까요?
사용자 질문
    |
    v
get_current_weather("Seoul")
    |
    v
get_tomorrow_weather("Daejeon")
    |
    v
최종 답변
서울의 현재 날씨를 조회했기 때문에 기대한 실행 경로와 다릅니다.
따라서 Tool 평가에서 실패할 수 있습니다.
어떤 부분을 비교하는가?
기본적인 EXACT 방식에서는 다음을 엄격하게 비교합니다.
| 비교 항목 | 기대값 | 실제값 |
| 첫 번째 Tool | get_tomorrow_weather | get_tomorrow_weather |
| 첫 번째 인자 | Seoul | Seoul |
| 두 번째 Tool | get_tomorrow_weather | get_tomorrow_weather |
| 두 번째 인자 | Daejeon | Daejeon |
| 호출 순서 | 서울 → 대전 | 서울 → 대전 |
이 모든 것이 일치하면 1.0을 받을 수 있습니다.
ADK에는 EXACT, IN_ORDER, ANY_ORDER와 같은 Tool 호출 비교 방식이 있습니다. 기본 방식은 EXACT이며, 이 방식은 추가 호출이나 누락된 호출도 허용하지 않습니다.
점수의 의미는 다음과 같습니다.
| 점수 | 의미 |
| 1.0 | 기대한 Tool 호출 경로와 완전히 일치 |
| 0.8 | 평가 기준에 따라 일부 불일치가 허용된 상태 |
| 0.5 | 기대한 호출과 실제 호출 사이에 상당한 차이가 있음 |
| 0.0 | 기대한 호출 경로와 일치하지 않음 |
이번 테스트에서는 기준점수가 1.0이므로 모든 기대 Tool 호출이 정확하게 일치해야 통과합니다.
이번에 통과한 이유
앞서 확인한 평가 결과에서 실제 호출은 다음과 같았습니다.
get_tomorrow_weather(location="Seoul")
get_tomorrow_weather(location="Daejeon")
기대 호출과 실제 호출이 일치했습니다.
따라서:
tool_trajectory_avg_score = 1.0이 된 것입니다.
즉, 이제 Agent가 질문을 이해하고 올바른 Tool을 선택하는 부분은 해결됐다고 볼 수 있습니다.
6-3. response_match_score 상세 해설
두 번째 평가 지표입니다.
이 지표는 Agent가 생성한 최종 답변과 JSON에 기록된 기대 답변을 비교합니다.
이번 JSON의 기대 답변은 다음과 같습니다.
내일은 서울이 최고 기온 24도로 대전의
최고 기온 20도보다 더 따뜻하겠습니다.
그런데 이전 실행에서 Agent가 다음과 같이 답변했습니다.
내일 최고기온(max_temp) 기준으로
서울이 대전보다 더 따뜻합니다.

서울: 최고기온 24°C
대전: 최고기온 20°C
사람이 보면 정답입니다.
그런데 ADK의 response_match_score는 단순히 사람이 읽었을 때 의미가 맞는지를 판단하는 지표가 아닙니다.
이 지표는 ROUGE-1이라는 텍스트 유사도 평가 방식을 사용합니다. 쉽게 말해 기대 답변과 실제 답변에 공통으로 포함된 단어가 얼마나 많은지 측정합니다.
ROUGE-1을 쉽게 이해하기
기대 답변이 다음과 같다고 가정하겠습니다.
서울은 대전보다 더 따뜻합니다.실제 답변이 다음과 같다면:
서울이 대전보다 기온이 높습니다.사람은 두 문장의 의미가 같다고 이해합니다.
그러나 두 문장에 공통으로 등장하는 단어는 제한적입니다.
반대로 실제 답변이 다음과 같다면:
서울은 대전보다 더 따뜻합니다.기대 답변과 거의 동일하기 때문에 유사도 점수가 높게 나옵니다.
이것이 ROUGE-1의 특징입니다.
왜 이전에는 0.568이 나왔을까?
이전 평가 결과의 점수는 다음과 같았습니다.
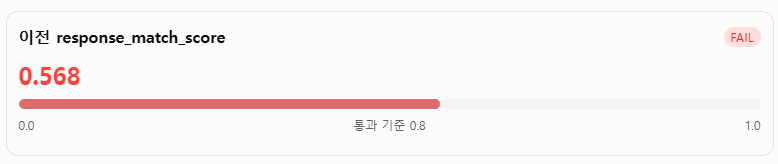
이유는 실제 답변에 다음과 같은 추가 표현이 들어갔기 때문입니다.
-
max_temp라는 필드명
-
최저기온 정보
-
날씨 상태 정보
-
Markdown 제목과 목록
-
기대 답변과 다른 문장 구조
따라서 사실관계는 맞더라도 기대 답변과 단어의 겹침 정도가 충분하지 않았던 것입니다.
이번에 Instruction을 수정한 것은 바로 이 문제를 해결하기 위한 것이었습니다.
response_match_score에서 기억할 점
이 점수는 실제 업무의 정답률과 동일한 의미가 아닙니다.
예를 들어 다음 두 문장은 의미가 같습니다.
서울이 대전보다 더 따뜻합니다.
대전보다 서울의 기온이 더 높습니다.
하지만 ROUGE-1은 표현 차이 때문에 낮은 점수를 줄 수 있습니다.
따라서 이 지표는 다음 상황에서 유용합니다.
-
정해진 형식으로 답변하는 Agent
-
특정 문구나 수치를 반드시 포함해야 하는 Agent
-
반복적인 자동 회귀 테스트
-
답변 형식이 일정해야 하는 업무
반면 자유로운 대화나 다양한 표현을 허용하는 Agent에는 의미 중심의 평가가 더 적합할 수 있습니다.
ADK에는 참고 답변과 의미적으로 일치하는지를 LLM이 판단하는 final_response_match_v2도 있습니다. 이 방식은 단어가 다르더라도 의미가 같은 답변을 평가하는 데 더 적합합니다.
7. 평가 결과 JSON을 읽는 방법
이제 실제 평가 결과 파일을 읽는 방법을 살펴보겠습니다.
앞서 첨부했던 평가 결과에는 다음과 같은 항목들이 있었습니다.
"overall_eval_metric_results": [
    {
        "metric_name": "tool_trajectory_avg_score",
        "threshold": 1.0,
        "score": 1.0,
        "eval_status": 1
    },
    {
        "metric_name": "response_match_score",
        "threshold": 0.8,
        "score": 0.568,
        "eval_status": 2
    }
]
각 항목을 이해해 보겠습니다.
7-1. metric_name
"metric_name": "tool_trajectory_avg_score"평가 지표의 이름입니다.
어떤 항목을 평가하고 있는지를 알려줍니다.
7-2. threshold
"threshold": 1.0평가 통과 기준입니다.
예를 들어:
"threshold": 0.8이면 해당 지표의 점수가 0.8 이상이어야 통과합니다.
이번 테스트의 기준은 다음과 같습니다.
| 평가 지표 | 통과 기준 |
| tool_trajectory_avg_score | 1.0 |
| response_match_score | 0.8 |
7-3. score
"score": 0.568실제 평가에서 나온 점수입니다.
통과 기준과 비교하면 됩니다.
예를 들어:
score = 0.568
threshold = 0.8
이므로 실패입니다.
7-4. eval_status
"eval_status": 1해당 평가 항목의 상태를 나타냅니다.
앞서 제공한 결과에서는 tool_trajectory_avg_score가 통과 상태, response_match_score가 실패 상태로 기록됐습니다.
숫자 자체만 외우기보다는 평가 결과 화면이나 각 metric의 상태 설명과 함께 해석하는 것이 좋습니다.
7-5. 실제 실행 기록 확인
이번 실습에서는 다음과 같은 JSON 항목도 중요합니다.
"actual_invocation": {
    ...
}
이 부분은 실제 Agent가 실행한 기록입니다.
여기서 다음을 확인할 수 있습니다.
-
사용자가 입력한 질문
-
Agent가 생성한 최종 답변
-
실제 Tool 호출
-
Tool에 전달한 인자
-
Tool의 반환값
-
실행 시간
-
모델 사용량
특히 다음 부분이 중요합니다.
"function_call": {
    "args": {
        "location": "Seoul"
    },
    "name": "get_tomorrow_weather"
}
이것을 보면 Agent가 실제로 어떤 Tool을 어떤 인자로 호출했는지 알 수 있습니다.
그리고 Tool의 반환값은 다음처럼 기록됩니다.
"response": {
    "city": "서울",
    "weather": "Cloudy",
    "temperature": 21,
    "min_temp": 13,
    "max_temp": 24,
    "humidity": 50,
    "description": "내일 서울은 구름이 많지만 야외 활동은 가능합니다."
}
이 부분을 통해 Tool이 실제로 올바른 데이터를 반환했는지 확인할 수 있습니다.
실무에서 평가 결과를 분석할 때는 최종 점수만 보지 말고 실제 실행 기록까지 확인하는 습관이 중요합니다.
7-6. 성능과 비용을 보여주는 지표
앞서 평가 결과에는 품질 평가 외에도 다음과 같은 지표가 있었습니다.
| 지표 | 의미 | 단위 |
| tool_call_count_v1 | Tool 호출 횟수 | 회 |
| inference_call_count_v1 | 모델 추론 횟수 | 회 |
| token_usage_v1 | 모델이 사용한 토큰 | 토큰 |
| invocation_duration_v1 | 전체 실행 시간 | 초 |
이 지표들은 Agent의 성능과 효율을 분석하는 데 사용합니다. 일반적으로 이 지표들 자체는 PASS/FAIL을 결정하는 품질 평가 기준이 아니라 실행 특성을 관찰하는 지표입니다.
앞서 공유한 이전 결과를 예로 들어보겠습니다.
① tool_call_count_v1
"score": 2.0Tool을 두 번 호출했다는 뜻입니다.
이번 질문에서는 서울과 대전의 내일 날씨를 각각 조회해야 하므로 2회가 적절합니다.
② inference_call_count_v1
"score": 2.0LLM이 추론을 수행한 횟수입니다.
이번 실행에서는 모델 호출이 두 번 이루어졌습니다.
일반적인 Tool 사용 Agent는 다음과 같은 흐름을 가질 수 있습니다.
첫 번째 모델 호출
    |
    v
Tool 선택 및 호출 요청
    |
    v
Python Tool 실행
    |
    v
두 번째 모델 호출
    |
    v
최종 답변 생성
여기서 Tool 두 개를 한 번의 모델 응답에서 동시에 요청할 수도 있습니다. 실제로 앞서 공유한 평가 결과에서는 두 Tool 호출이 같은 모델 응답에 포함되어 있었습니다.
따라서 Tool 호출 횟수와 모델 추론 횟수는 서로 같은 개념이 아닙니다.
③ token_usage_v1
"score": 1920.0모델이 사용한 토큰 수입니다.
이전 결과에서는 다음과 같이 기록됐습니다.
| 항목 | 토큰 수 |
| 입력 토큰 | 1,460 |
| 출력 토큰 | 460 |
| 전체 토큰 | 1,920 |
입력 토큰에는 사용자 질문뿐 아니라 Agent Instruction, Tool 설명 등 모델에 전달되는 여러 정보가 포함될 수 있습니다.
출력 토큰은 모델이 생성한 내용과 추론 과정 등에 관련된 토큰 사용량으로 나뉘어 기록될 수 있습니다.
토큰 사용량은 API 사용 비용과 실행 효율을 분석할 때 중요합니다.
④ invocation_duration_v1
"score": 6.36전체 실행에 걸린 시간이 약 6.36초였다는 의미입니다.
이전 결과의 상세 내역은 다음과 같았습니다.
| 항목 | 시간 |
| 전체 실행 시간 | 6.360초 |
| 모델 처리 시간 | 5.388초 |
| Tool 실행 시간 | 0.002초 |
| 프레임워크 처리 시간 | 0.970초 |
여기서 흥미로운 점은 Tool 실행 시간이 매우 짧다는 것입니다.
왜 그럴까요?
이번 Tool은 외부 API를 호출하지 않고 Python Dictionary에서 데이터를 가져오기 때문입니다.
실제 서비스에서 기상청 API를 호출하거나 여러 외부 시스템을 조회하면 Tool 실행 시간이 훨씬 길어질 수 있습니다.
정리하면 품질 지표와 효율 지표를 함께 보는 습관을 들이는 것이 좋습니다.
-
품질: 정확하게 답변했는가?
-
효율: 몇 번 호출했는가?
-
비용: 토큰을 얼마나 사용했는가?
-
속도: 얼마나 빨리 실행됐는가?
8. 실제 실행 및 평가 방법
이제 실제 PC에서 어떻게 실행하는지 정리하겠습니다.
8-1. 가상환경 활성화
현재 사용하는 ADK 실습 폴더로 이동합니다.
cd C:\Dev\book_agentic_ai\adk_사용 중인 가상환경을 활성화합니다.
예를 들어 가상환경 이름이 venv라면:
.\venv\Scripts\Activate.ps1가상환경이 활성화되면 PowerShell 앞에 (venv)와 같이 표시됩니다.
8-2. 평가 패키지 설치
pip install "google-adk[eval]"일반 ADK 설치에 평가 기능에 필요한 의존성을 추가하는 명령입니다.
이미 설치되어 있다면 다시 설치할 필요는 없습니다.
설치된 버전을 확인하려면:
pip show google-adk8-3. 폴더와 파일 확인
다음 명령으로 프로젝트 구조를 확인합니다.
tree /F평가 대상 폴더가 다음처럼 구성되어 있어야 합니다.
weather_eval_agent
│
├── __init__.py
│
└── weather_agent.py
평가 데이터도 다음 위치에 있어야 합니다.
evals
│
└── seoul_daejeon_weather.test.json
여기서 weather_eval_agent와 evals의 위치를 혼동하지 않는 것이 중요합니다.
-
첫 번째 경로: 실제 실행할 Agent
-
두 번째 경로: 평가할 테스트 데이터
8-4. 평가 실행
이제 다음 명령을 실행합니다.
adk eval .\weather_eval_agent\ .\evals\seoul_daejeon_weather.test.json명령을 구성 요소별로 보면 다음과 같습니다.
adk eval
    |
    +-- .\weather_eval_agent\
    |       평가할 Agent 애플리케이션
    |
    +-- .\evals\seoul_daejeon_weather.test.json
            평가 데이터 파일
즉, 다음과 같이 읽으면 됩니다.
weather_eval_agent 폴더에 있는 Agent를 불러와서 seoul_daejeon_weather.test.json에 정의된 테스트를 실행하라.
이번에는 adk web을 먼저 실행할 필요 없이 CLI에서 직접 평가할 수 있습니다.
8-5. 평가 결과 확인
평가가 끝나면 콘솔에 다음과 같은 형태의 결과가 출력됩니다.
Tests passed: 1
Tests failed: 0

Overall Eval Status: PASSED
이것이 가장 먼저 확인해야 할 내용입니다.
그다음 각 평가 지표를 확인합니다.
Metric: tool_trajectory_avg_score
Status: PASSED
Score: 1.0
Threshold: 1.0
Metric: response_match_score
Status: PASSED
Score: 0.8 이상
Threshold: 0.8두 항목 모두 통과해야 이번 평가 기준으로 성공입니다.
참고로 실제 최신 실행 결과의 점수는 이번 메시지에 별도로 첨부되지 않았으므로, 여기서는 이전 실행의 0.568과 구분해서 설명하고 있습니다.
9. 평가가 실패했을 때 어디부터 확인해야 하는가?
이번에 우리가 직접 경험했던 내용이므로 꼭 정리해 두면 좋겠습니다.
평가가 실패했다고 무조건 코드를 전부 수정할 필요는 없습니다.
어떤 평가 지표가 실패했는지를 먼저 확인하고, 그 지표에 해당하는 부분만 조사하면 됩니다.
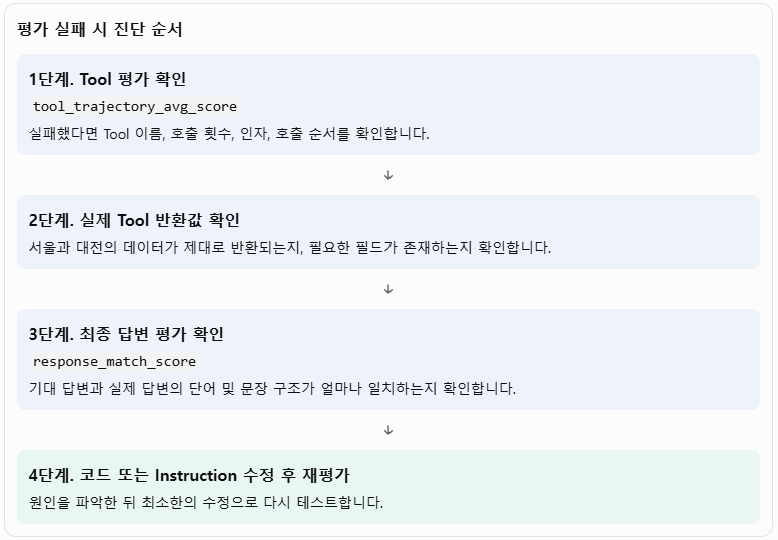
실제 사례를 기준으로 살펴보겠습니다.
사례 A. Tool 평가가 실패한 경우
예를 들어 다음처럼 나왔다고 가정하겠습니다.
tool_trajectory_avg_score = 0.0이때는 다음을 확인해야 합니다.
-
tools에 함수가 제대로 등록되어 있는가?
-
Agent Instruction에서 Tool 선택 기준이 명확한가?
-
get_tomorrow_weather를 호출해야 하는데 get_current_weather를 호출하지는 않았는가?
-
location 인자가 Seoul과 Daejeon으로 정확하게 전달됐는가?
-
평가용 Agent 폴더와 테스트 JSON의 app_name이 일치하는가?
이번 실습의 초기 문제에서는 바로 이 부분을 확인해야 했습니다.
기존 GCS Artifact Agent가 평가 대상으로 로딩되면서 평가용 Agent와 다른 도구들이 실행됐기 때문입니다.
그래서 별도 weather_eval_agent 폴더를 만들어 평가 대상을 분리했습니다.
이 경험은 상당히 중요합니다.
평가 실패의 원인이 Python 함수 내부에만 있는 것은 아닙니다. 평가기가 어떤 Agent를 실제로 불러왔는지도 확인해야 합니다.
사례 B. Tool 평가는 통과했지만 답변 평가가 실패한 경우
이번에 겪었던 문제입니다.
tool_trajectory_avg_score = 1.0
response_match_score = 0.568
이 경우에는 Tool 코드를 무조건 수정할 필요가 없습니다.
다음 순서로 확인하면 됩니다.
-
실제 Tool 호출이 올바른가?
-
Tool 반환값이 올바른가?
-
실제 답변에 정답이 포함되어 있는가?
-
기대 답변과 표현이 지나치게 다른가?
-
불필요한 설명이나 Markdown이 추가되었는가?
이번에는 Tool 호출도 맞고 반환 데이터도 맞았습니다.
따라서 Instruction에 답변 형식을 추가하는 것으로 해결했습니다.
사례 C. Tool 평가는 통과했는데 데이터가 틀린 경우
이 경우는 조금 더 주의해야 합니다.
예를 들어 Agent가 다음과 같이 호출했다고 가정하겠습니다.
get_tomorrow_weather("Seoul")
get_tomorrow_weather("Daejeon")
호출 자체는 정확합니다.
그런데 Tool이 잘못된 데이터를 반환했다면 어떻게 될까요?
서울 max_temp = 20
대전 max_temp = 24
Agent는 그 잘못된 데이터에 따라 대전이 더 따뜻하다고 답변할 것입니다.
Tool 호출 경로 평가만으로는 데이터의 정확성까지 검증했다고 볼 수 없습니다.
이번 테스트 JSON의 intermediate_responses는 비어 있으므로, 현재 테스트는 Tool 호출 경로를 명시적으로 검증하지만 기대 Tool 반환값을 별도로 비교하는 구성은 아닙니다.
따라서 실제 서비스에서는 다음과 같은 데이터 검증 테스트도 추가하는 것이 좋습니다.
def test_tomorrow_weather_data():

    seoul = get_tomorrow_weather("Seoul")
    daejeon = get_tomorrow_weather("Daejeon")

    assert seoul["max_temp"] == 24
    assert daejeon["max_temp"] == 20

    assert seoul["city"] == "서울"
    assert daejeon["city"] == "대전"
이 코드는 Agent를 거치지 않고 Python Tool 자체의 결과를 검증합니다.
이렇게 하면 다음 두 가지를 분리해서 검사할 수 있습니다.
-
Tool 함수 자체가 올바르게 작동하는가?
-
Agent가 Tool을 올바르게 선택하고 사용하는가?
이것이 좋은 테스트 구조입니다.
10. 이번 코드를 더 좋은 Agent로 발전시키려면?
이번 실습 코드는 Agent 평가의 기본 구조를 이해하기에 아주 좋습니다. 이제 이 구조를 조금 더 확장해 보겠습니다.
10-1. 평가 사례를 늘리기
현재 테스트는 하나입니다.
compare_case_01
서울과 대전 중 내일 어디가 더 따뜻해?
그런데 실제 Agent라면 여러 상황을 테스트해야 합니다.
제가 추천하는 다음 평가 세트는 다음과 같습니다.
| 테스트 ID | 사용자 질문 | 기대 Tool |
| current_seoul_01 | 서울 현재 날씨 알려줘 | get_current_weather(Seoul) |
| current_daejeon_01 | 대전 현재 날씨 알려줘 | get_current_weather(Daejeon) |
| tomorrow_seoul_01 | 서울 내일 날씨 알려줘 | get_tomorrow_weather(Seoul) |
| tomorrow_daejeon_01 | 대전 내일 날씨 알려줘 | get_tomorrow_weather(Daejeon) |
| compare_case_01 | 서울과 대전 중 내일 어디가 더 따뜻해? | get_tomorrow_weather 2회 |
| unsupported_city_01 | 부산 내일 날씨 알려줘 | 지원 불가 처리 |
이렇게 하면 Agent가 단순히 한 가지 질문만 잘 처리하는 것이 아니라 여러 상황에서 일관되게 작동하는지 검증할 수 있습니다.
10-2. 현재 날씨와 내일 날씨를 구분하는 능력 검증
다음 두 질문은 서로 다른 Tool을 호출해야 합니다.
서울 현재 날씨 알려줘.서울 내일 날씨 알려줘.Agent가 질문의 시간적 의미를 이해하고 적절한 Tool을 선택하는지를 테스트하는 것입니다.
이것은 실제 업무 Agent에서도 매우 중요합니다.
예를 들어 문서 Agent라면 다음과 같은 구분이 있을 수 있습니다.
-
현재 문서 조회
-
과거 문서 조회
-
신규 문서 작성
-
기존 문서 수정
질문이 비슷하더라도 실행해야 할 Tool은 달라질 수 있습니다.
10-3. 데이터 정확성 검증과 Agent 평가를 분리하기
이번 실습을 발전시킨다면 세 단계로 나누는 것을 추천합니다.
Python Tool 단위 테스트
함수가 정확한 데이터를 반환하는가?
assert get_tomorrow_weather("Seoul")["max_temp"] == 24Agent Tool 사용 평가
질문에 따라 올바른 Tool을 호출하는가?
tool_trajectory_avg_scoreAgent 최종 답변 평가
올바른 데이터를 근거로 기대한 답변을 만드는가?
response_match_score이렇게 분리하면 문제가 발생했을 때 원인을 훨씬 빠르게 찾을 수 있습니다.
10-4. 향후에는 실제 날씨 API로 교체
현재는 다음과 같은 Mock Data를 사용하고 있습니다.
MOCK_TOMORROW_WEATHER_DATA실제 서비스를 만들 때는 이 부분을 외부 날씨 API로 교체하면 됩니다.
예를 들어:
사용자
  |
  v
Weather Agent
  |
  v
get_tomorrow_weather()
  |
  v
외부 날씨 API
  |
  v
날씨 데이터 반환
  |
  v
Agent 답변 생성
중요한 것은 Agent의 기본 구조를 그대로 유지할 수 있다는 점입니다.
사용자 질문을 이해하고 Tool을 선택하는 Agent의 역할은 그대로입니다.
바뀌는 것은 Tool 내부의 데이터 조회 방식입니다.
이런 구조로 만들면 Mock Data를 이용한 개발 및 평가가 끝난 후 실제 API를 연결하는 방식으로 발전시킬 수 있습니다.
11. 이번 실습에서 반드시 기억할 핵심 개념
지금까지의 내용을 핵심 개념 중심으로 다시 정리하겠습니다.
| Agent | LLM을 중심으로 질문을 이해하고 Tool을 선택하는 실행 주체 |
| Tool | 실제 작업을 수행하는 Python 함수 |
| Mock Data | 테스트용으로 미리 준비한 가상 데이터 |
| normalize | 다양한 입력을 내부에서 사용할 일관된 값으로 변환 |
| Instruction | Agent의 업무 규칙과 답변 형식 |
| tools | Agent가 사용할 수 있도록 등록한 함수 목록 |
| root_agent | ADK가 찾아 실행할 Agent의 진입점 |
| evalset | 평가할 질문과 기대 결과의 집합 |
| eval_case | 개별 평가 시나리오 |
| tool_uses | 기대하는 Tool 호출과 인자 |
| final_response | 기대하는 최종 답변 |
| tool_trajectory_avg_score | Tool 호출 경로 평가 |
| response_match_score | 최종 답변의 ROUGE-1 유사도 평가 |
| threshold | 평가 통과 기준 |
이번 실습에서 얻은 가장 중요한 교훈 5가지
첫째, Agent를 만들었다고 해서 제대로 작동하는 것은 아닙니다.
실행 결과를 평가하고 검증해야 합니다.
둘째, Tool을 정확히 호출하는 것과 Tool이 정확한 데이터를 반환하는 것은 다릅니다.
두 가지를 각각 테스트해야 합니다.
셋째, Agent Instruction은 단순한 역할 설명이 아닙니다.
어떤 Tool을 사용하고, 어떤 순서로 작업하며, 어떤 기준으로 결과를 판단하고, 어떤 형식으로 답변해야 하는지를 구체적으로 지정할 수 있습니다.
넷째, 평가 데이터는 일종의 시험 문제와 정답지입니다.
사용자 질문, 기대 Tool 호출, 기대 답변을 미리 정의해 두면 Agent가 변경되더라도 기존 기능이 정상적으로 작동하는지 반복해서 확인할 수 있습니다.
다섯째, 평가 점수는 반드시 그 의미를 이해하고 해석해야 합니다.
특히 response_match_score는 의미적 정답률이 아니라 단어 유사도에 기반한 지표라는 점을 기억해야 합니다.
12. 앞으로의 학습 방향
이번 실습을 통해 Agent 개발의 중요한 한 단계를 경험했습니다.
지금까지 공부한 내용을 연결해 보면 다음과 같은 흐름입니다.
Agent 개발 학습 흐름
-
Agent 기본 구조 이해
LLM, Agent, Instruction, Tool
-
Tool 구현
Python 함수를 Agent가 사용할 수 있도록 등록
-
Agent 실행
사용자 질문에 따라 Tool을 선택하고 결과를 반환
-
외부 서비스 연결
API, 데이터베이스, GCS 등과 연동
-
Agent 평가 — 이번 실습
Evalset, Tool Trajectory, Response Match
-
Agent 품질 개선
정확성, 신뢰성, 응답 형식, 실행 비용 개선
-
멀티에이전트 평가
Manager Agent와 Weather·Research·Document Agent 간 협업 평가
특히 다음 단계에서는 이번에 만든 weather_agent를 기반으로 평가 사례를 여러 개 추가하고, Tool 단위 테스트와 ADK Eval을 함께 실행하는 구조를 만들어 보면 좋겠습니다.
그렇게 하면 이후 A2A로 연결한 Weather Agent, Research Agent, Document Agent에도 동일한 평가 원리를 적용할 수 있습니다.
마지막으로 한 문장으로 정리하면, 이번 실습은 "Agent를 만드는 방법"에서 "Agent가 제대로 일하는지 검증하는 방법"으로 학습 범위를 확장한 과정입니다.
이 개념은 앞으로 개발할 Agent가 복잡해질수록 더 중요해집니다.